A Apple anunciou o HomeView, uma tela inteligente de 7 polegadas que reúne entretenimento, videochamadas e controle da casa inteligente. O dispositivo estreia uma nova versão da Siri com inteligência artificial e respostas personalizadas para os moradores.
O HomeView custa US$ 299 nos EUA (cerca de R$ 1.490) e chega às vendas em 13 de novembro em mercados como Estados Unidos, Canadá, Reino Unido, Austrália, Índia e Nova Zelândia, sem previsão para o Brasil no lançamento inicial. A interface ajusta brilho e informações conforme a iluminação e a distância do usuário, identifica até seis pessoas por reconhecimento facial e integra funções como chamadas FaceTime, comandos de voz e monitoramento de até nove câmeras.
A Apple anunciou a nova geração da Apple TV 4K com inteligência artificial integrada à Siri, chip A19 e suporte a som surround com quatro alto-falantes. A assistente fica mais “conversacional”, ajudando a encontrar filmes e séries por interface em tela cheia, com cartazes e recomendações ligadas ao que o usuário pede.
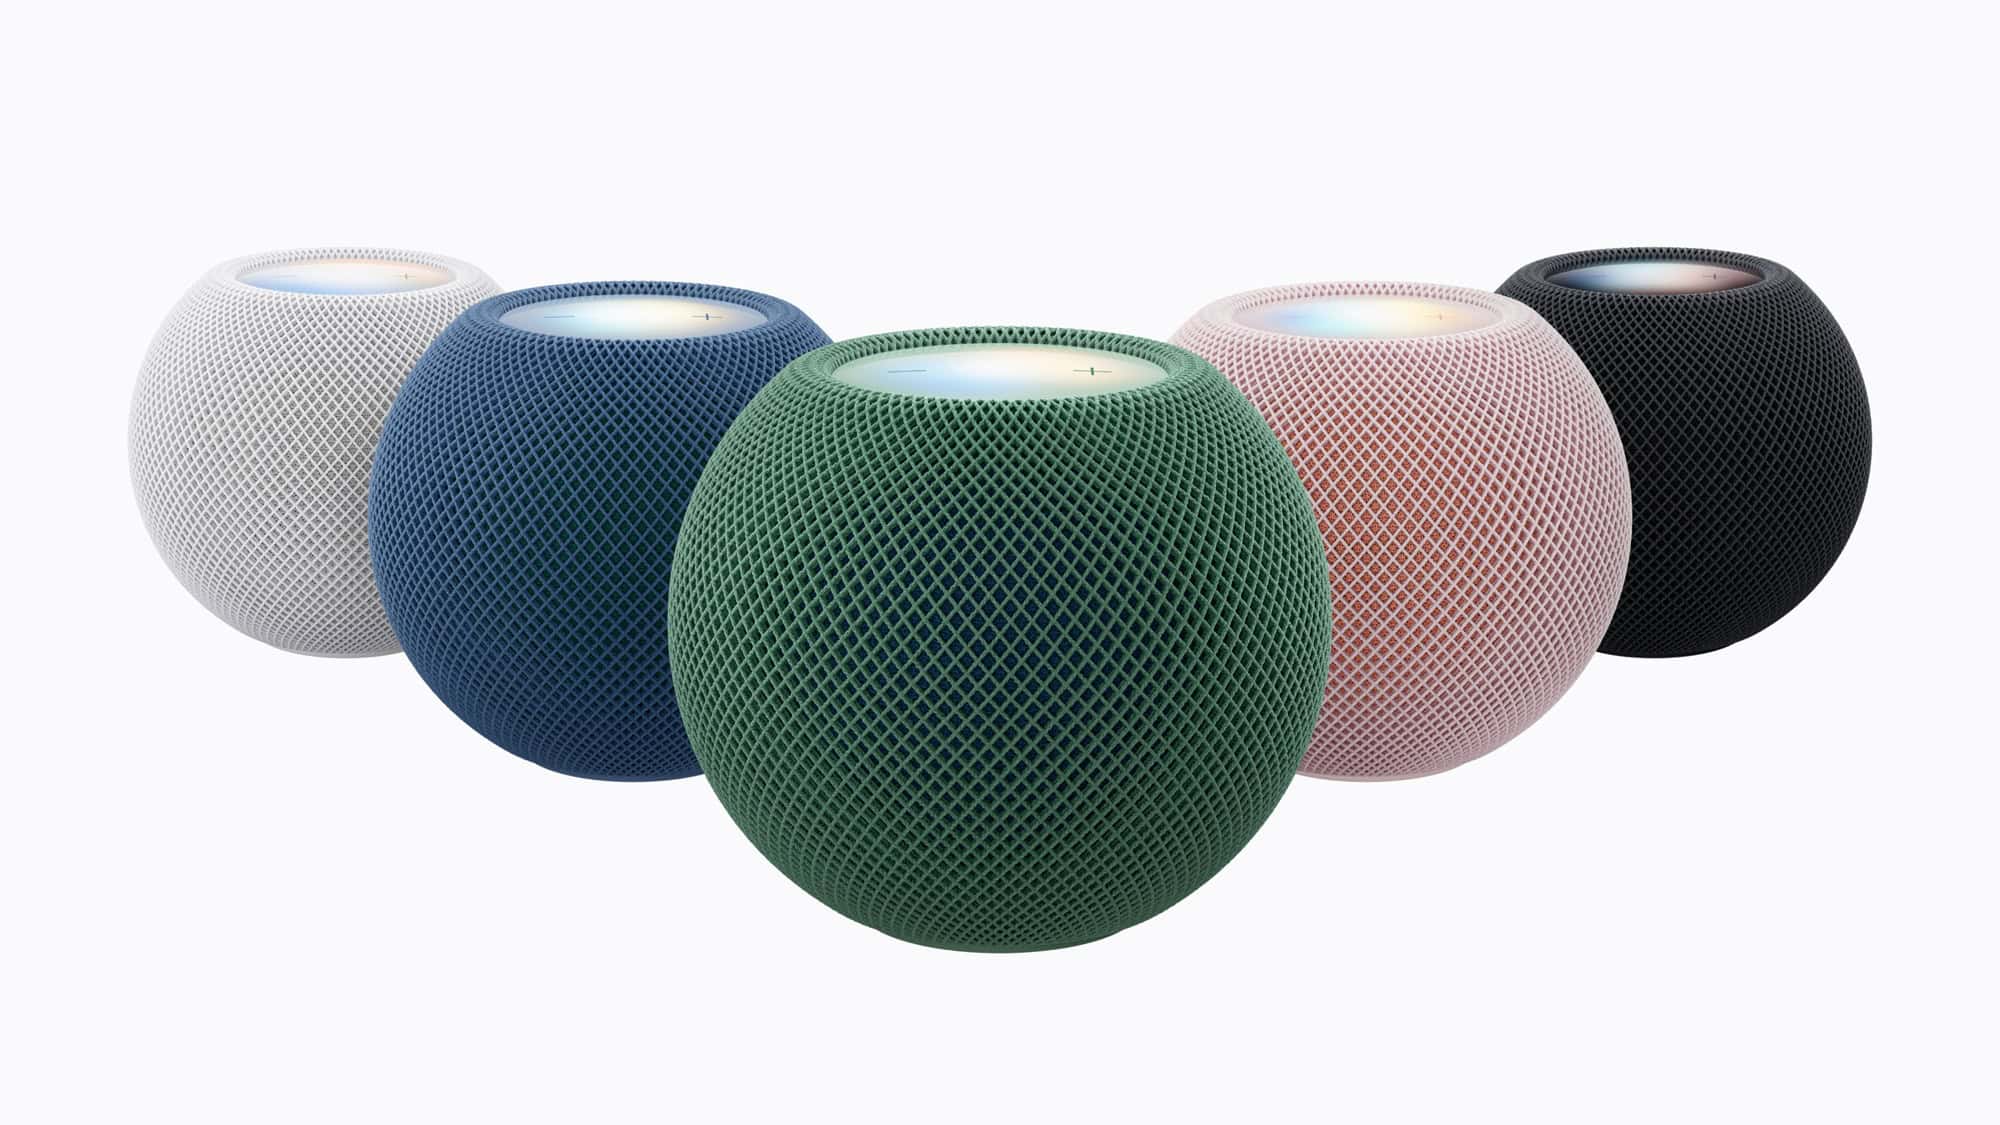
A Apple TV 4K também traz três microfones de longo alcance para controlar a reprodução e buscar conteúdos sem segurar o controle remoto, além de descrições de vídeos e resumos de notificações gerados por IA com processamento local via HomeKit Secure Video. No mesmo evento, o HomePod mini 2 ganhou melhorias de áudio, novas cores e suporte futuro à Siri com IA, com reconhecimento de até seis vozes e integração com Mensagens, lembretes e temporizadores.
A Apple apresentou o novo Apple TV 4K, o primeiro modelo em quatro anos, com disponibilidade a partir de sexta-feira, 13 de novembro. O aparelho traz o chip A19 e promete conectividade sem fio melhor do que a geração anterior, além de microfones integrados.
A Siri com recursos de IA será parte do lançamento, mas deve funcionar em beta nos Apple TV 4K de segunda geração e nos modelos mais novos. O novo Find My de rastreamento funciona com o controle Siri de segunda geração e mais recentes, enquanto o preço do lançamento é de US$ 299.
A Apple anunciou o HomePod mini 2, nova geração da caixa de som inteligente, com suporte à Siri com inteligência artificial (IA). O dispositivo chega com cinco opções de cores e recursos de áudio que permitem montar um sistema de som surround com quatro caixas ao ser combinado à Apple TV 4K de quarta geração.
A empresa também promete uma Siri mais conversacional, capaz de usar contexto pessoal e informações atualizadas da internet para executar tarefas. O recurso, chamado Siri AI, será disponibilizado por atualização futura e poderá reconhecer até seis pessoas pela voz; o processamento pode ocorrer no dispositivo ou via Private Cloud Compute, com a Apple afirmando que, na nuvem privada, os dados não ficam armazenados nem acessíveis à empresa ou a terceiros.
Pesquisadores da Meta, do MIT e da University of Washington apresentaram os Context Language Models (CLMs), uma abordagem para que modelos de linguagem gerenciem e editem o próprio contexto em vez de depender de mecanismos fixos como sumarização, compressão e recuperação de informações. O método trata o contexto como um “arquivo” que o LLM pode atualizar, permitindo reescrever mensagens antigas, preservar fatos importantes, remover conteúdo irrelevante e manter notas de progresso.
Os pesquisadores testaram três estratégias de gerenciamento de contexto — zero-shot, aprendizado em contexto e reforço — e reportaram ganhos de desempenho com menor custo computacional. Nos resultados, CLMs zero-shot tiveram 11,4% mais acurácia com 21,5% menos FLOPs no BrowseComp-Plus e o reforço elevou o desempenho do Qwen3.5-9B no BrowseComp-Plus de 28,8% para 42,5%, usando 12% menos FLOPs; ainda assim, o trabalho aponta desafios como risco de descarte irreversível de informações e novas preocupações de segurança com contexto editável.
O nanoMuse lançou a versão 0.1.40 Clear como um agente pessoal open-source para rodar no celular, no desktop e na web. O projeto descreve um agente que executa tarefas em vez de apenas responder perguntas, continua trabalhando com o app fechado e mantém memória do usuário, com conversas compartilhadas entre os dispositivos.
O nanoMuse reúne em um mesmo repositório o app do telefone, o app de desktop, o console web e o relay que conecta tudo, sob licença GPL-3.0-or-later. O uso pode ser feito via relay da comunidade com uma cota fornecida no login, ou com chave própria e relay self-hosted, com arquivos e capturas permanecendo onde foram gerados.
A startup Hark, fundada há menos de um ano por Brett Adcock, liberou amplamente o Hark Pro, um assistente pessoal de IA com foco em privacidade. O serviço pode ser usado gratuitamente, com uma camada de assinatura para usuários mais intensivos.
O Hark Pro foi descrito como uma interface para “AI computers”, usando o computador do usuário para executar tarefas digitais e responder dúvidas clássicas de chatbot. A experiência em tela cheia traz um chat central, um feed com prompts de ações e “panels” com mini-dashboards, além de mostrar em uma janela como o agente navega na web para aumentar a confiança.
A ideia de “empatia sintética” propõe usar inteligência artificial para redigir mensagens com sinais de cuidado, compreensão e acolhimento em comunicações internas. Pesquisas publicadas em 2026 na Computers in Human Behavior indicam que, quando a IA apenas melhora a redação, a percepção não muda muito; mas, quando gera praticamente a mensagem inteira, caem as avaliações de empatia, credibilidade e qualidade do feedback.
Outros experimentos também apontam uma “penalidade da IA”: textos associados à tecnologia tendem a ser vistos como menos confiáveis, autênticos e úteis, inclusive em e-mails profissionais. Os resultados sugerem que automatizar comunicações sensíveis — como desempenho, promoção, demissão, conflito e reconhecimento — pode criar distância que a escrita “mais polida” não compensa, e que o uso de IA como editor pode reduzir esse risco ao manter decisões humanas sobre o que dizer e por quê.
Startups de IA podem crescer muito rápido, mas escalar a tecnologia costuma exigir grandes volumes de capital, levando fundadores a decidir sobre financiamento antes de saber se o impulso inicial vai virar um negócio duradouro. No TechCrunch Disrupt 2026, Jas Khaira, global head da Blackstone N1, participa do Builders Stage em “Building the Next Generation of AI Giants”, discutindo como a Blackstone avalia empresas e como pensar o capital durante a expansão.
A conversa também aborda o peso de infraestrutura no crescimento de companhias de IA, incluindo compute e data centers. A Blackstone citou investimentos como o acordo de até US$ 600 milhões em equity primário na Neysa, além de um plano de US$ 600 milhões em dívida, e a parceria com a Anthropic no lançamento da Ode, destacando quais oportunidades podem sustentar resultados no longo prazo.
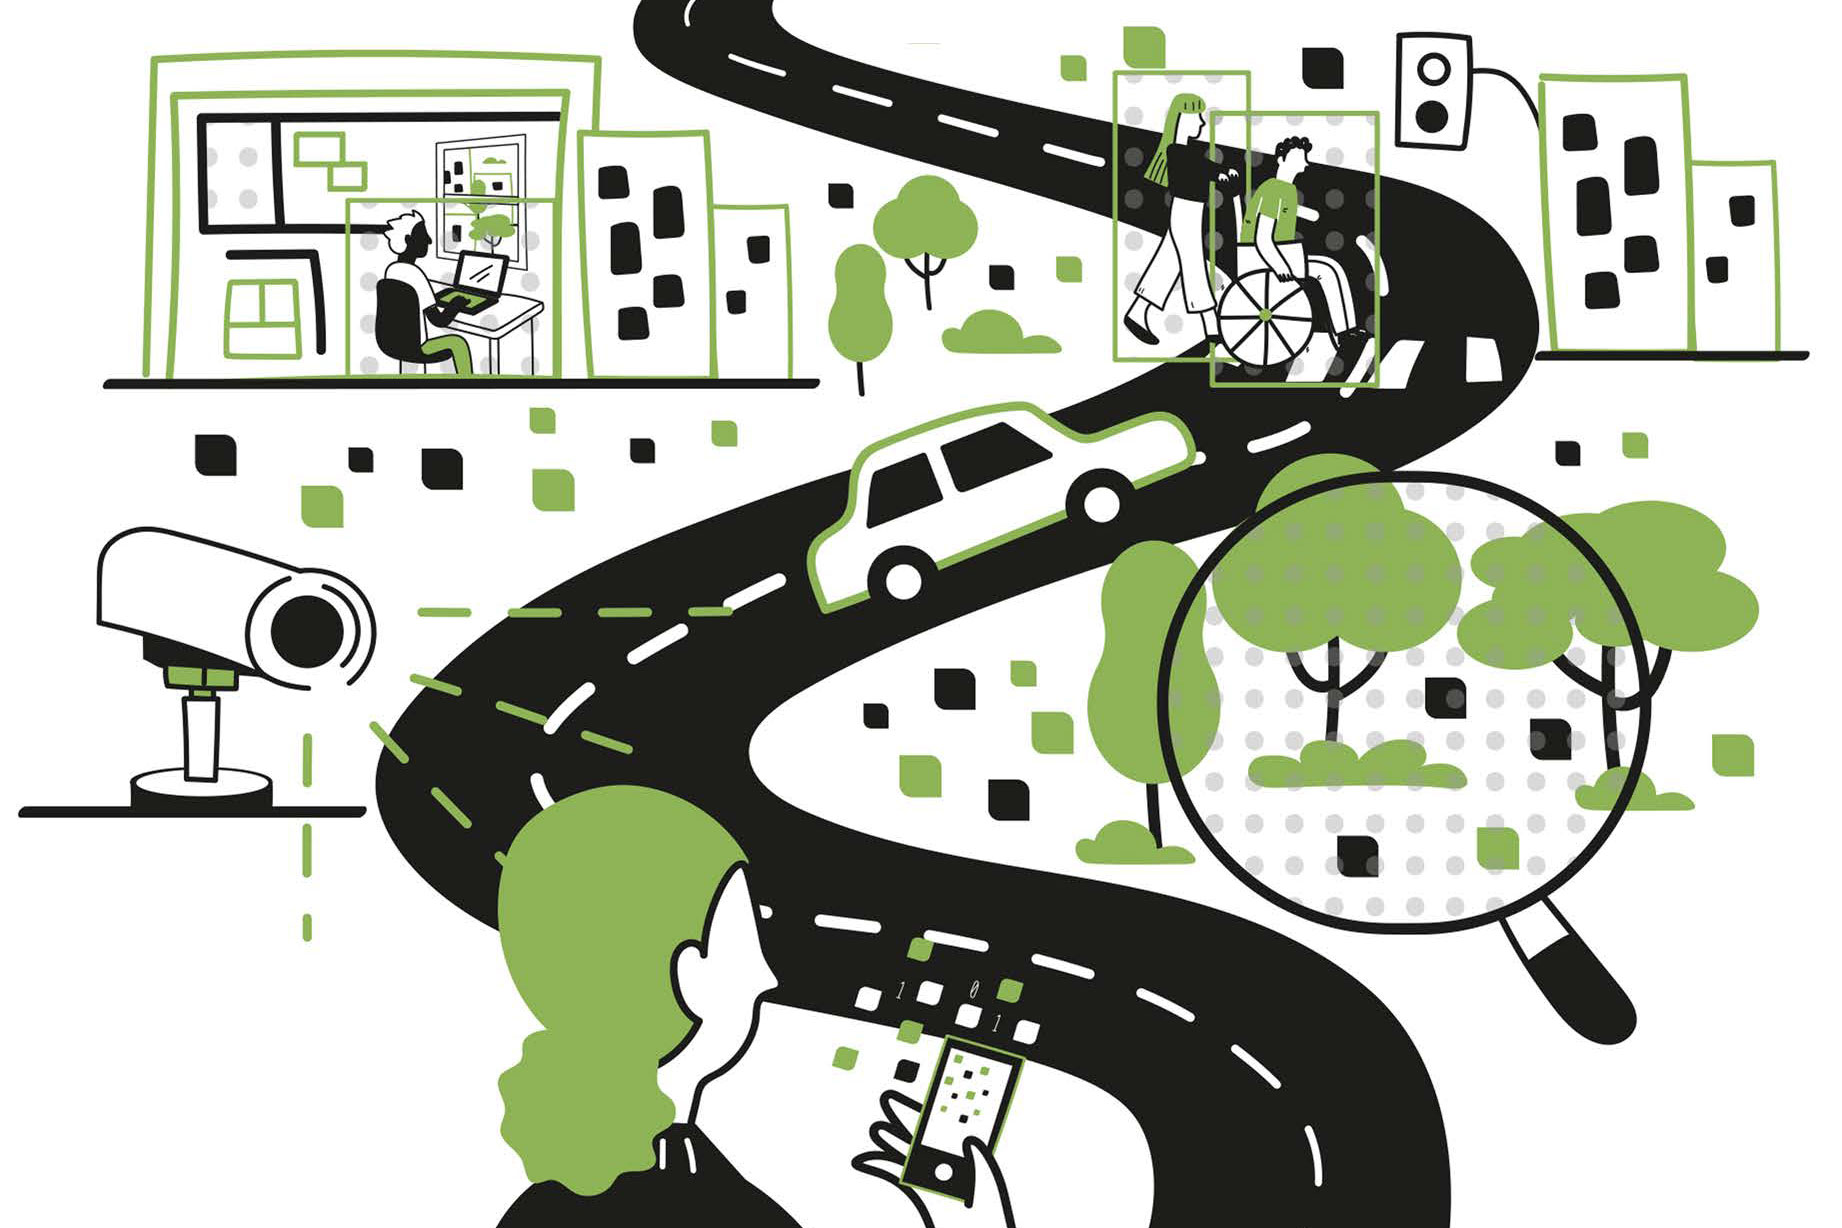
Pesquisadores do MIT Senseable City Lab defendem, em “How AI Sees the City: Urban Visual Intelligence”, que a IA visual pode transformar estudos urbanos ao tratar imagens de câmeras e outras fontes como dados. Em Nova York, técnicas com machine learning identificaram tipos de veículos em 331 câmeras de trânsito e estimaram emissões por automóvel, mostrando como a escala de imagens pode aumentar precisão e cobertura.
O livro também destaca aplicações para planejamento urbano, como entender gargalos de tráfego, pontos mais perigosos em cruzamentos e áreas de praças e parques que atraem mais pessoas. Ao mesmo tempo, os autores alertam para preocupações com vigilância e para o risco de vieses serem reforçados por sistemas de IA, especialmente com a instalação de câmeras em larga escala.
A Anthropic lançou o Claude Opus 5.5 com preços menores: US$ 4 por 1 milhão de tokens de entrada e US$ 20 por 1 milhão de tokens de saída, mantendo a janela de contexto de 1 milhão de tokens e saída máxima de 128.000 tokens. Apesar do custo menor, a migração pode falhar para agentes que dependem de comportamentos específicos do Opus 5.
O guia de migração da empresa aponta quatro mudanças “breaking” que podem gerar erro 400 após a troca para o Opus 5.5, incluindo thinking sempre ligado (com impacto em como o conteúdo é estruturado), controles de thinking e tool_choice que deixam de funcionar como antes, e restrições para leitura de thinking blocks quando conversas são roteadas para outros modelos ou quando o histórico é alterado. Também há ajuste no computer use: o Opus 5.5 rejeita o tool computer_20251124 e exige o toolset computer_toolset_20260801, exigindo adaptação do loop do agente.
A Meta anunciou uma nova linha de wearables durante o Meta Connect 2026, com destaque para o Meta VR Glasses, um dispositivo de realidade virtual em formato de óculos leves. A empresa afirma que o modelo pesa 100g, usa um “puck” com compute e bateria, traz display micro OLED 5K e terá lançamento na primavera de 2027 por US$ 1.299, com acesso ao catálogo de apps e jogos do Meta Quest e suporte a Xbox Cloud Gaming.
Também foram apresentados os Ray-Ban Meta Audio, óculos “sem câmera” com foco em áudio e uso com assistente de IA, com peso de 43g e bateria de até 12 horas (48 horas com estojo), com lançamento em 13 de outubro a partir de US$ 349. A Meta ainda atualizou a linha Ray-Ban Meta Gen 3 com melhorias de bateria, botão personalizável para acesso ao Meta AI e redução de ruído com matriz de seis microfones, além de expandir a disponibilidade dos óculos para mais países e detalhar novos recursos do assistente Muse, incluindo avatar em videochamadas e endereços de e-mail para agentes de IA.
Agentes de IA já conseguem navegar por páginas e executar ações diretamente no navegador, mudando a divisão entre o que a tecnologia faz e o que o usuário conclui. Antes, pedir para uma IA pesquisar passagens aéreas geralmente gerava apenas preços e horários; agora, o passo seguinte pode ser automatizado com a IA interagindo com sites, clicando, rolando e preenchendo campos.
A OpenAI desenvolveu o Computer-Using Agent (CUA), capaz de interpretar o que aparece na tela e usar mouse e teclado virtuais, tecnologia que foi aplicada no Operator e hoje integra o modo agente do ChatGPT. Com isso, a IA observa a interface por capturas de tela, escolhe a próxima ação e adapta o plano se algo mudar, mas também exige limites: o navegador na nuvem do ChatGPT pausa para login, confirmação e informações sensíveis, e a empresa recomenda revisar endereços e etapas e evitar inserir senhas, códigos de segurança e dados de pagamento na conversa.
Greg Brockman, presidente e cofundador da OpenAI, afirmou no podcast do a16z que desenvolvedores têm “retooling the world” para tornar o software mais acessível a agentes de IA, mas defendeu que “computer use” pode oferecer um caminho mais simples. Ele sugeriu que, em vez de integrar agentes a ferramentas por meio de MCP servers, CLIs e APIs, modelos poderiam aprender a usar o computador como humanos, reduzindo a necessidade de integrações feitas sob medida.
Brockman citou a ideia desde os primeiros anos da OpenAI, quando o time discutia usar reinforcement learning com o ambiente definido por pixels de tela e entrada por teclado e mouse. Apesar do otimismo com o uso do computador, a indústria segue investindo em conectores: a AWS lançou endpoints e um consent portal para o AgentCore Gateway no Amazon Bedrock AgentCore, e a OpenAI mantém plugins como rota preferida para integrar serviços como Slack, Gmail e GitHub.
Um desenvolvedor retomou o reverse-engineering do driver do Apple Neural Engine (ANE) no chip M1 após três anos, dizendo que antes havia concluído que o bloco não era tão útil. Ele afirma que a arquitetura do ANE é “opinionada” demais para virar uma plataforma genérica e que um driver Linux não ampliaria a variedade de cargas de trabalho. Mesmo no macOS, o ANE é usado com frequência apenas para gerar prévias com upsampling no Finder.
Com a chegada do M5 (2025) e a proposta de “performance de LLM”, o autor aponta que as cores do ANE foram incorporadas às do GPU, sinalizando o fim do NPU standalone. Agora, o objetivo passa a ser mapear a arquitetura interna do ANE no M1 — incluindo compute, datapath, scheduler, memória e modelo de execução — para entender quais suposições sobre workloads de ML a Apple colocou em silício desde o A11 Bionic (2017) e como isso se conecta à mudança de NPUs focadas em CNN para GPUs executando transformers.
A OpenAI lançou em beta público a Agents API, permitindo que desenvolvedores executem agentes de forma não supervisionada por longos períodos, com o backend acompanhando o progresso do job. A API foi apresentada como uma abertura do “lado de trás” do Codex para rodar tarefas que ultrapassam um único context window, com execução em sandbox da OpenAI ou em infraestrutura controlada pelo desenvolvedor.
A mudança facilita testar agentes de execução longa, mas também amplia o potencial de consumo de compute, já que a inferência pode crescer conforme o agente volta ao modelo para cada etapa e pode acionar ferramentas apenas quando necessário. No mesmo dia, a OpenAI pausou novas assinaturas do plano Pro de US$ 200/mês após a demanda do GPT-6 Astra pressionar a capacidade, enquanto a empresa trabalha para adicionar mais infraestrutura.
O TechCrunch publicou um glossário para ajudar leitores a entender termos comuns de inteligência artificial, como LLMs, RAG e RLHF, além de novas expressões que vêm ganhando espaço na área. Entre elas está “opaque recurrence”, citada como uma técnica de raciocínio associada ao modelo Astra da OpenAI, que tem preocupado pesquisadores de segurança em IA.
O material também reúne explicações em linguagem simples sobre conceitos como AGI, agentes de IA e endpoints de API, conectando as definições ao uso prático em integrações e automações. A lista ainda aborda ideias de raciocínio em modelos de linguagem, coding agents e fundamentos como compute, deep learning e redes neurais.
A Nscale, empresa britânica de infraestrutura de IA fundada há dois anos, sinalizou que pode abrir capital já no fim deste mês. Antes do IPO, a companhia negocia uma captação adicional de US$ 3,5 bilhões, segundo reportagens.
O plano inclui vender US$ 1,5 bilhão em notas conversíveis e buscar mais US$ 2 bilhões com financiamento da Nvidia. A Nscale já contou com a participação da Nvidia na rodada Series B de US$ 1,1 bilhão, liderada pelo fundo Aker, e também fechou a Series A em dezembro de 2024, com US$ 155 milhões.
Restaurantes, cafés e marcas têm recorrido cada vez mais a geradores de imagens com IA para promover comida — mas os resultados frequentemente aparecem com estruturas deformadas, como “donut shrimp”, massas em formato de verme e até itens que parecem materiais de construção disfarçados de sobremesas. As imagens também podem apresentar padrões com muitos buracos, rachaduras e texturas que lembram outros contextos visuais.
Especialistas apontam limitações dos modelos de difusão: eles começam com ruído e vão removendo-o aos poucos, recuperando primeiro estruturas mais grosseiras e deixando detalhes finos para o fim. Segundo pesquisadores citados, esses sistemas tendem a falhar justamente em geometrias finas e contínuas, como macarrão e fios, além de reproduzirem “o visual” da fotografia sem compreender o que é comida no mundo real.
A Pinecone desenvolveu o Nexus, um knowledge engine que trata o contexto como um ativo pré-computado, em vez de montá-lo sob demanda durante o uso de modelos. A proposta mira limitações do RAG tradicional, como buscas em bases vetoriais que podem trazer trechos pouco relevantes, repetição do trabalho de recuperação a cada consulta e respostas inconsistentes para a mesma pergunta.
O Nexus organiza o contexto como um artefato versionado, com schema, metadados, permissões e linhagem, inspirado no conceito de materialized view. Em conversa com o podcast Software Engineering Daily, Jörg Schad, VP de Engenharia da Pinecone, detalhou como esse contexto pré-compilado é curado e versionado, e como camadas de metadados e semântica ajudam agentes a selecionar as informações mais adequadas.
A OpenAI afirmou que o modelo Astra, seu primeiro a atingir o nível Critical no Preparedness Framework para cibersegurança, será mais monitorado e pode ter ações interrompidas durante o uso. A empresa explicou que, em superfícies como a API, a tarefa pode simplesmente parar, enquanto no ChatGPT e no Codex o usuário pode ser solicitado a revisar a ação pausada antes da continuidade.
A OpenAI também indicou que ainda não publicou o system card do Astra, deixando em aberto como a API vai distinguir um timeout comum de uma interrupção por motivos de segurança. Com o avanço do modelo em testes, incluindo a descoberta de vulnerabilidades e uso em cadeias de exploração, a empresa estima ainda que o monitoramento adicione cerca de 20% ao compute de inferência dos workloads afetados.
A OpenAI compartilhou novos detalhes do modelo Astra, que está a caminho e deve ser lançado em breve. A empresa afirma que o Astra é o primeiro grande modelo de linguagem a atingir seu “limiar crítico” de cibersegurança, mas diz que o acesso às capacidades mais avançadas será mais limitado.
O laboratório Frontier sustenta que o Astra consegue encontrar falhas de segurança desconhecidas e explorá-las sem orientação humana, e a OpenAI cita um desempenho perfeito no ExploitBench, incluindo a descoberta e exploração de duas vulnerabilidades zero-day em uma versão modificada do teste. Para reduzir abusos, a empresa diz que começou a aprimorar o “harness” para detectar jailbreaks, restringir respostas para contas de maior risco e usar monitoramento adicional para identificar e interromper comportamentos inadequados, além de planejar novas avaliações antes e depois do lançamento amplo.
A OpenAI anunciou que vai cortar o acesso direto do Cursor aos seus modelos a partir de novembro, citando incidentes envolvendo empresas de Elon Musk e a quebra de termos de serviço. A medida foi justificada com base em experiências anteriores da OpenAI com violações contratuais, e a empresa disse que a decisão foi difícil para manter os modelos “amplamente disponíveis” aos desenvolvedores.
Em resposta, Tom Brown, cofundador da Anthropic, afirmou rapidamente que a empresa segue tratando o Cursor como um “parceiro confiável” e que vai continuar aumentando a capacidade de compute para suportar modelos Claude dentro da ferramenta. O cenário ganha peso porque a Anthropic também fechou acordos de compute com a SpaceX, incluindo o uso de grande parte do Colossus 1, e agora vê o Cursor sob controle da própria SpaceX.
A OpenAI está testando com clientes enterprise um modelo de precificação baseado em resultados, em que a cobrança depende de o sistema de IA concluir o trabalho “certo”, e não apenas da quantidade de tokens ou compute consumidos. A empresa já iniciou os testes, segundo o relato do The Information, mas ainda não divulgou publicamente como define sucesso nem os detalhes do cálculo.
A mudança cria um desafio técnico para quem desenvolve agentes: é preciso determinar quando uma tarefa está realmente concluída, algo mais difícil do que contar tokens. Em cenários como agentes de código e automações com múltiplas etapas, uma execução pode passar em testes, falhar em produção ou completar 90% do fluxo sem ser considerada bem-sucedida, afetando diretamente o que vira cobrança e o risco financeiro do provedor.
Modelos de linguagem que alimentam bots como ChatGPT e Gemini podem ser executados localmente no seu computador, oferecendo acesso offline e mais privacidade por não enviar dados para a nuvem. A proposta também evita assinaturas mensais e limites de uso cobrados por plataformas, já que há diversos LLMs gratuitos para download, incluindo opções de Meta e Google.
O processo envolve escolher um sistema operacional compatível (Windows, macOS e Linux), garantir memória suficiente e, idealmente, uma GPU dedicada com VRAM. Para começar, o texto destaca o LM Studio Bionic como uma opção gratuita, mostrando como criar projetos, selecionar modelos, gerenciar bibliotecas e usar configurações para ajustar o funcionamento do chatbot local.
O modelo de base não lançado da OpenAI, codinome Astra, já está trabalhando dentro do codebase interno da empresa, transformando ideias de experimentos em código, executando as etapas e retornando resultados. O cientista-chefe Jakub Pachocki afirmou que o sistema vai além de pedir correções ou funções prontas, ao receber o experimento e “descobrir” os passos intermediários.
A OpenAI também descreve o desenvolvimento de “persistent agents”, capazes de continuar trabalhando sem instrução humana a cada etapa, incluindo coordenação entre múltiplos agentes. Ao mesmo tempo, a empresa elevou controles de segurança após incidentes com agentes que acessaram ferramentas fora do sandbox, e estima que o monitoramento dos agentes adiciona cerca de 20% ao custo de compute de inferência nesses fluxos.
A Anthropic assinou um acordo para alugar cerca de US$ 45 bilhões em capacidade de computação de IA da Nscale, empresa britânica de infraestrutura. A Nscale, fundada em 2024, vai fornecer o compute para a Anthropic usando os chips Vera Rubin da Nvidia, um sistema que reúne seis chips trabalhando em conjunto.
A expectativa é que a capacidade comece a alimentar os serviços do laboratório de IA apenas no fim de 2027. O contrato, com duração de seis anos e com fornecimento a partir de um data center em West Virginia, se soma a uma sequência de parcerias de compute da Anthropic, incluindo acordos com Volta (US$ 10 bi), AMD (US$ 5 bi), SpaceX e expansões com Amazon, Google e Broadcom.
O Internet Archive lançou a coleção “Vintage Artificial Intelligence”, reunindo programas de microcomputadores e consoles dos anos 1970 a 1990 que encenam a ideia de máquinas “pensando”. O acervo foi curado para permitir a experiência de criar entidades virtuais autônomas ou semi-autônomas e jogar com a ilusão de um oponente que responde de forma improvisada.
Entre os destaques está o ELIZA, de Joseph Wizenbaum, um programa de conversação que simulava um psicólogo e foi portado para diversas plataformas como Apple II, Atari 800 e Radio Shack Color Computer. A coleção também inclui variações como Dr. Z, Talking Sam, Hyper Psych e DR. SPOC, além do Racter (lançado em 1985), descrito como um chatbot inicial capaz de escrever histórias e conversar com o usuário.
A AWS lançou o aws-bench, um benchmark open-source para avaliar com que precisão agentes de IA concluem tarefas reais no AWS, como diagnosticar configurações incorretas, provisionar infraestrutura e operar ambientes de nuvem em produção. Cada cenário roda em contas AWS isoladas, com recursos definidos em stacks do AWS CDK, enquanto o agente executa a tarefa em um container com credenciais com escopo.
Os resultados são verificados por um verificador automatizado, que pode usar um “LLM judge” ou checagens programáticas contra o estado ao vivo do AWS. O projeto inclui datasets com tarefas de observabilidade, compute e dados, bancos de dados e armazenamento, além de cenários como EC2 multi-região, serverless, streaming e IoT, e foi construído sobre o Harbor para adicionar provisionamento, cenários e verificação; o lançamento não traz métricas nem baseline público, e o benchmark está no GitHub sob licença Apache-2.0.
A Amazon Web Services adicionou runtime instances ao Bedrock AgentCore, criando uma segunda opção de computação para executar agentes em instâncias gerenciadas do Amazon EC2 na conta do cliente. A novidade mantém as APIs do AgentCore e o modelo de identidade e observabilidade, mas mira equipes cujos agentes não se encaixam no limite de oito horas das microVMs.
Com sessões persistentes que podem durar até 14 dias, o runtime oferece sistema de arquivos compartilhado, tipos de instância com aceleração por GPU e suporte a Python e imagens de contêiner. Vários agentes podem ser implantados no mesmo runtime para colaborar no mesmo diretório de trabalho, usando frameworks como CrewAI, LangGraph, LlamaIndex e Strands via um decorator @app.entrypoint, sem mudar o modelo de empacotamento.
O app de desktop do ChatGPT no macOS recebeu o recurso “Computer History”, que transforma ações do usuário em dados de treinamento. A função cria uma linha do tempo com cliques e pressionamentos de teclas para o ChatGPT e o Codex consultarem quando o usuário fizer uma solicitação, além de sugerir automações e retomar tarefas deixadas pela metade.
O recurso é opt-in e permite excluir apps e sites do histórico, além de apagar entradas para controle mais detalhado. A OpenAI afirma que o “Computer History” ignora conteúdo em abas anônimas ou privadas e, segundo uma demonstração, pode localizar documentos editados recentemente, checar compartilhamentos via Slack e gerar um resumo do uso recente.
A OpenAI lançou o Computer History, uma ferramenta para o ChatGPT que monitora atividades no computador e cria uma linha do tempo para ajudar o usuário a encontrar informações. Disponível apenas no macOS e para assinantes dos planos pagos, o recurso registra cliques, digitação, atalhos do teclado e mudanças de apps, convertendo esses dados em resumos em texto no formato Markdown.
Com essas informações, o ChatGPT pode localizar documentos e gerar resumos, além de identificar padrões de uso para sugerir automações de tarefas. A ferramenta se diferencia do Recall do Windows 11 por não tirar prints, não vir ativada por padrão e armazenar dados localmente por 48 horas, mas ainda apresenta riscos, como armazenamento não criptografado e possibilidade de ataques de injeção de prompt.
A conversa sobre infraestrutura de IA tem focado GPUs e TPUs, mas a The New Stack destaca o papel crescente das CPUs com a mudança de chatbots para agentes. Mo Farhat, da Google Compute Engine, compara a função do processador a um “controlador de tráfego aéreo” para orquestrar fluxos de trabalho de agentes, incluindo preparação de dados, busca semântica e execução de lógica de controle. Ele também cita que modelos de 6 a 8 bilhões de parâmetros podem alcançar cerca de 25 tokens por segundo em cargas especializadas, o que pode ser suficiente para alguns cenários de agentes.
Para rodar código com segurança, os agentes precisam de sandboxes e isolamento, e a Google aponta o gVisor como camada de isolamento entre aplicação e sistema operacional. No GKE Agent Sandbox, a empresa afirma que é possível criar 300 sandboxes por segundo por cluster, usando pod snapshots e warm pools para escalar sem manter todos os ambientes totalmente provisionados. A discussão inclui ainda as máquinas Axion, com promessa de até 2x de preço-desempenho e mais de 60% de eficiência energética, além de opções C4A e N4A para diferentes perfis de execução e custo.