A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
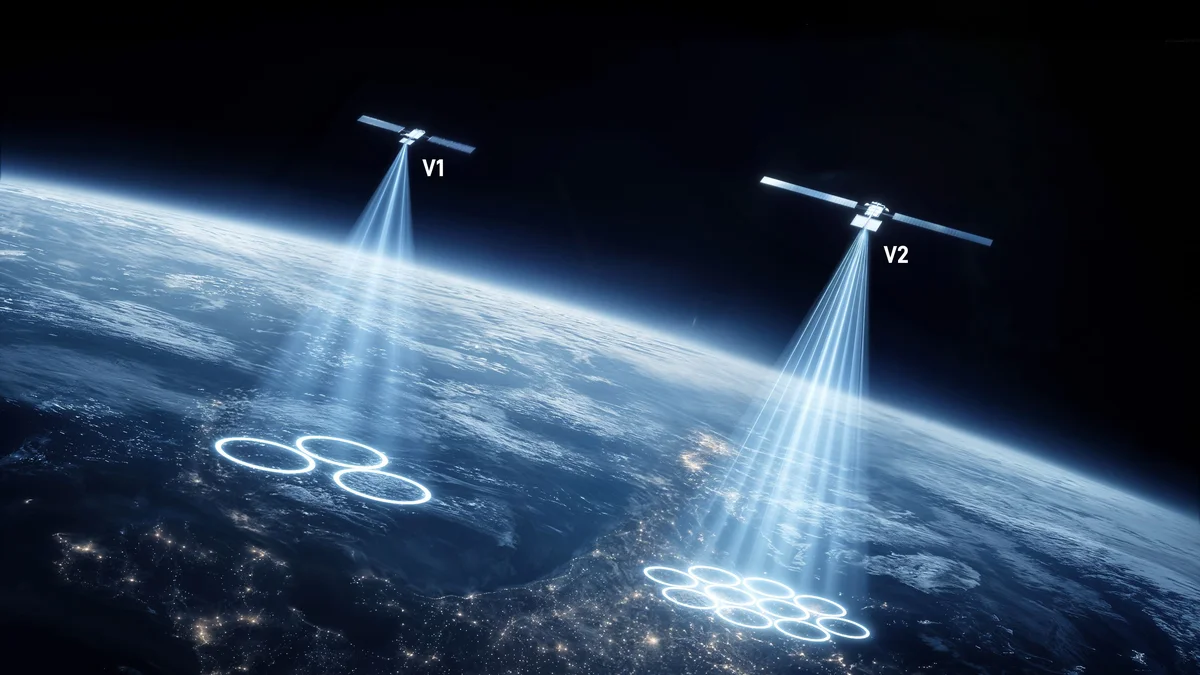
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
“The Sixty-Year Mission: How Star Trek Changed Television and the World” chegou ao público em estreia em Nova York e foi exibido durante a New York Comic Con, com lançamento em salas selecionadas. O documentário, escrito e dirigido por Mark A. Altman, foca na série original de Star Trek (1966 a 1969) e discute como a produção refletiu o clima político da época.
Além do impacto cultural, o filme também aborda a relação da franquia com inteligência artificial, citando o android Data de Star Trek: The Next Generation. A obra relembra como Data era mais inteligente que humanos, mas enfrentava dificuldades de entendimento e não tinha inteligência emocional, e ainda menciona o episódio “The Measure of a Man”, que questiona se ele era um ser próprio ou apenas propriedade.
O texto descreve a sensação de “pedir para a IA resolver” quando alguém solicita que você descubra algo, e a conversa termina com a ferramenta funcionando. O autor argumenta que, na maioria das vezes, a pessoa ajudada não conseguiria obter o mesmo resultado apenas pedindo a própria IA, por motivos como não usar serviços premium, ter resistência ao uso de IA ou estar desatualizada sobre ferramentas e termos.
A publicação também defende que saber formular a solicitação é parte essencial do processo, citando a ideia de que “conhecimento latente” e capacidade de orientar a IA fazem diferença. Por fim, sugere que a IA pode ser usada para tarefas práticas, enquanto a comunicação humana e o cuidado com o vínculo devem continuar sendo feitos à parte.
A Apple realizará um evento em 13 de outubro para apresentar novos produtos de casa conectada, com destaque para um smart hub próprio com tela de 6 polegadas e suporte à inteligência artificial Siri. O dispositivo deve funcionar como um painel de controle para equipamentos compatíveis com HomeKit e também pode permitir uso de apps, incluindo chamadas de vídeo, mensagens e reprodução de músicas.
Rumores também apontam atualização do HomePod Mini e uma nova versão do Apple TV com resolução 4K, chip A19 ou A19 Pro e integração com Siri e Apple Intelligence. Outra possibilidade é a Apple anunciar uma parceria com a LG para smart TVs com suporte nativo ao HomeKit e dispositivos como trinco inteligente, sensores e câmeras de segurança.
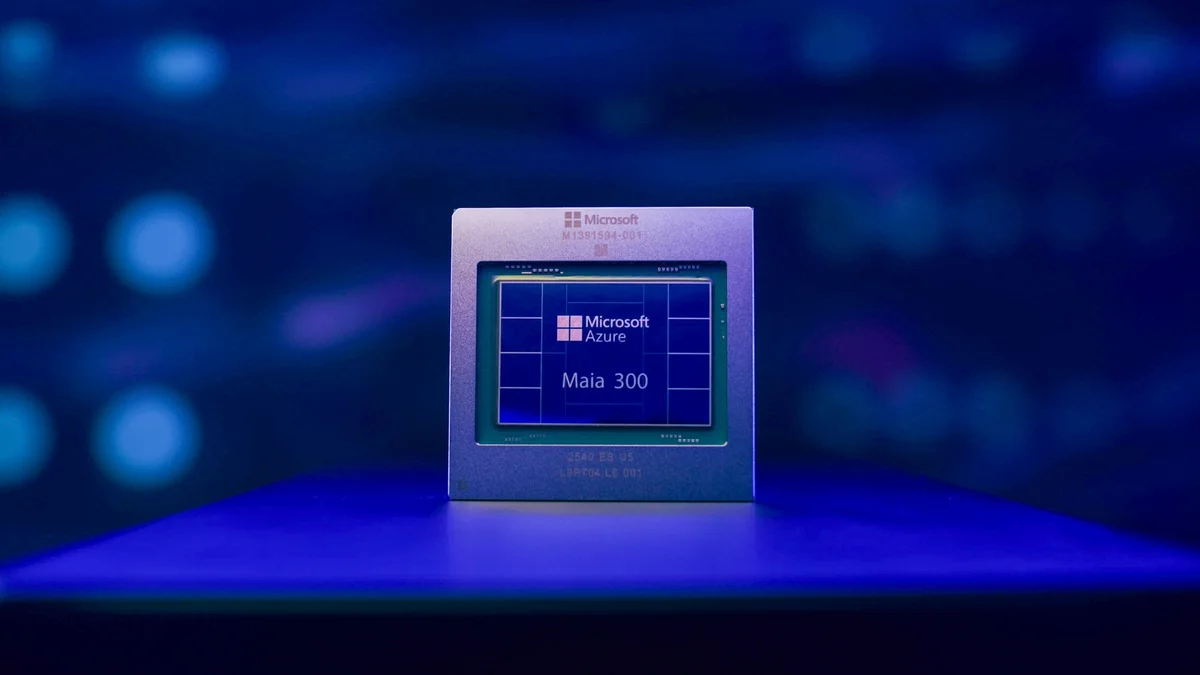
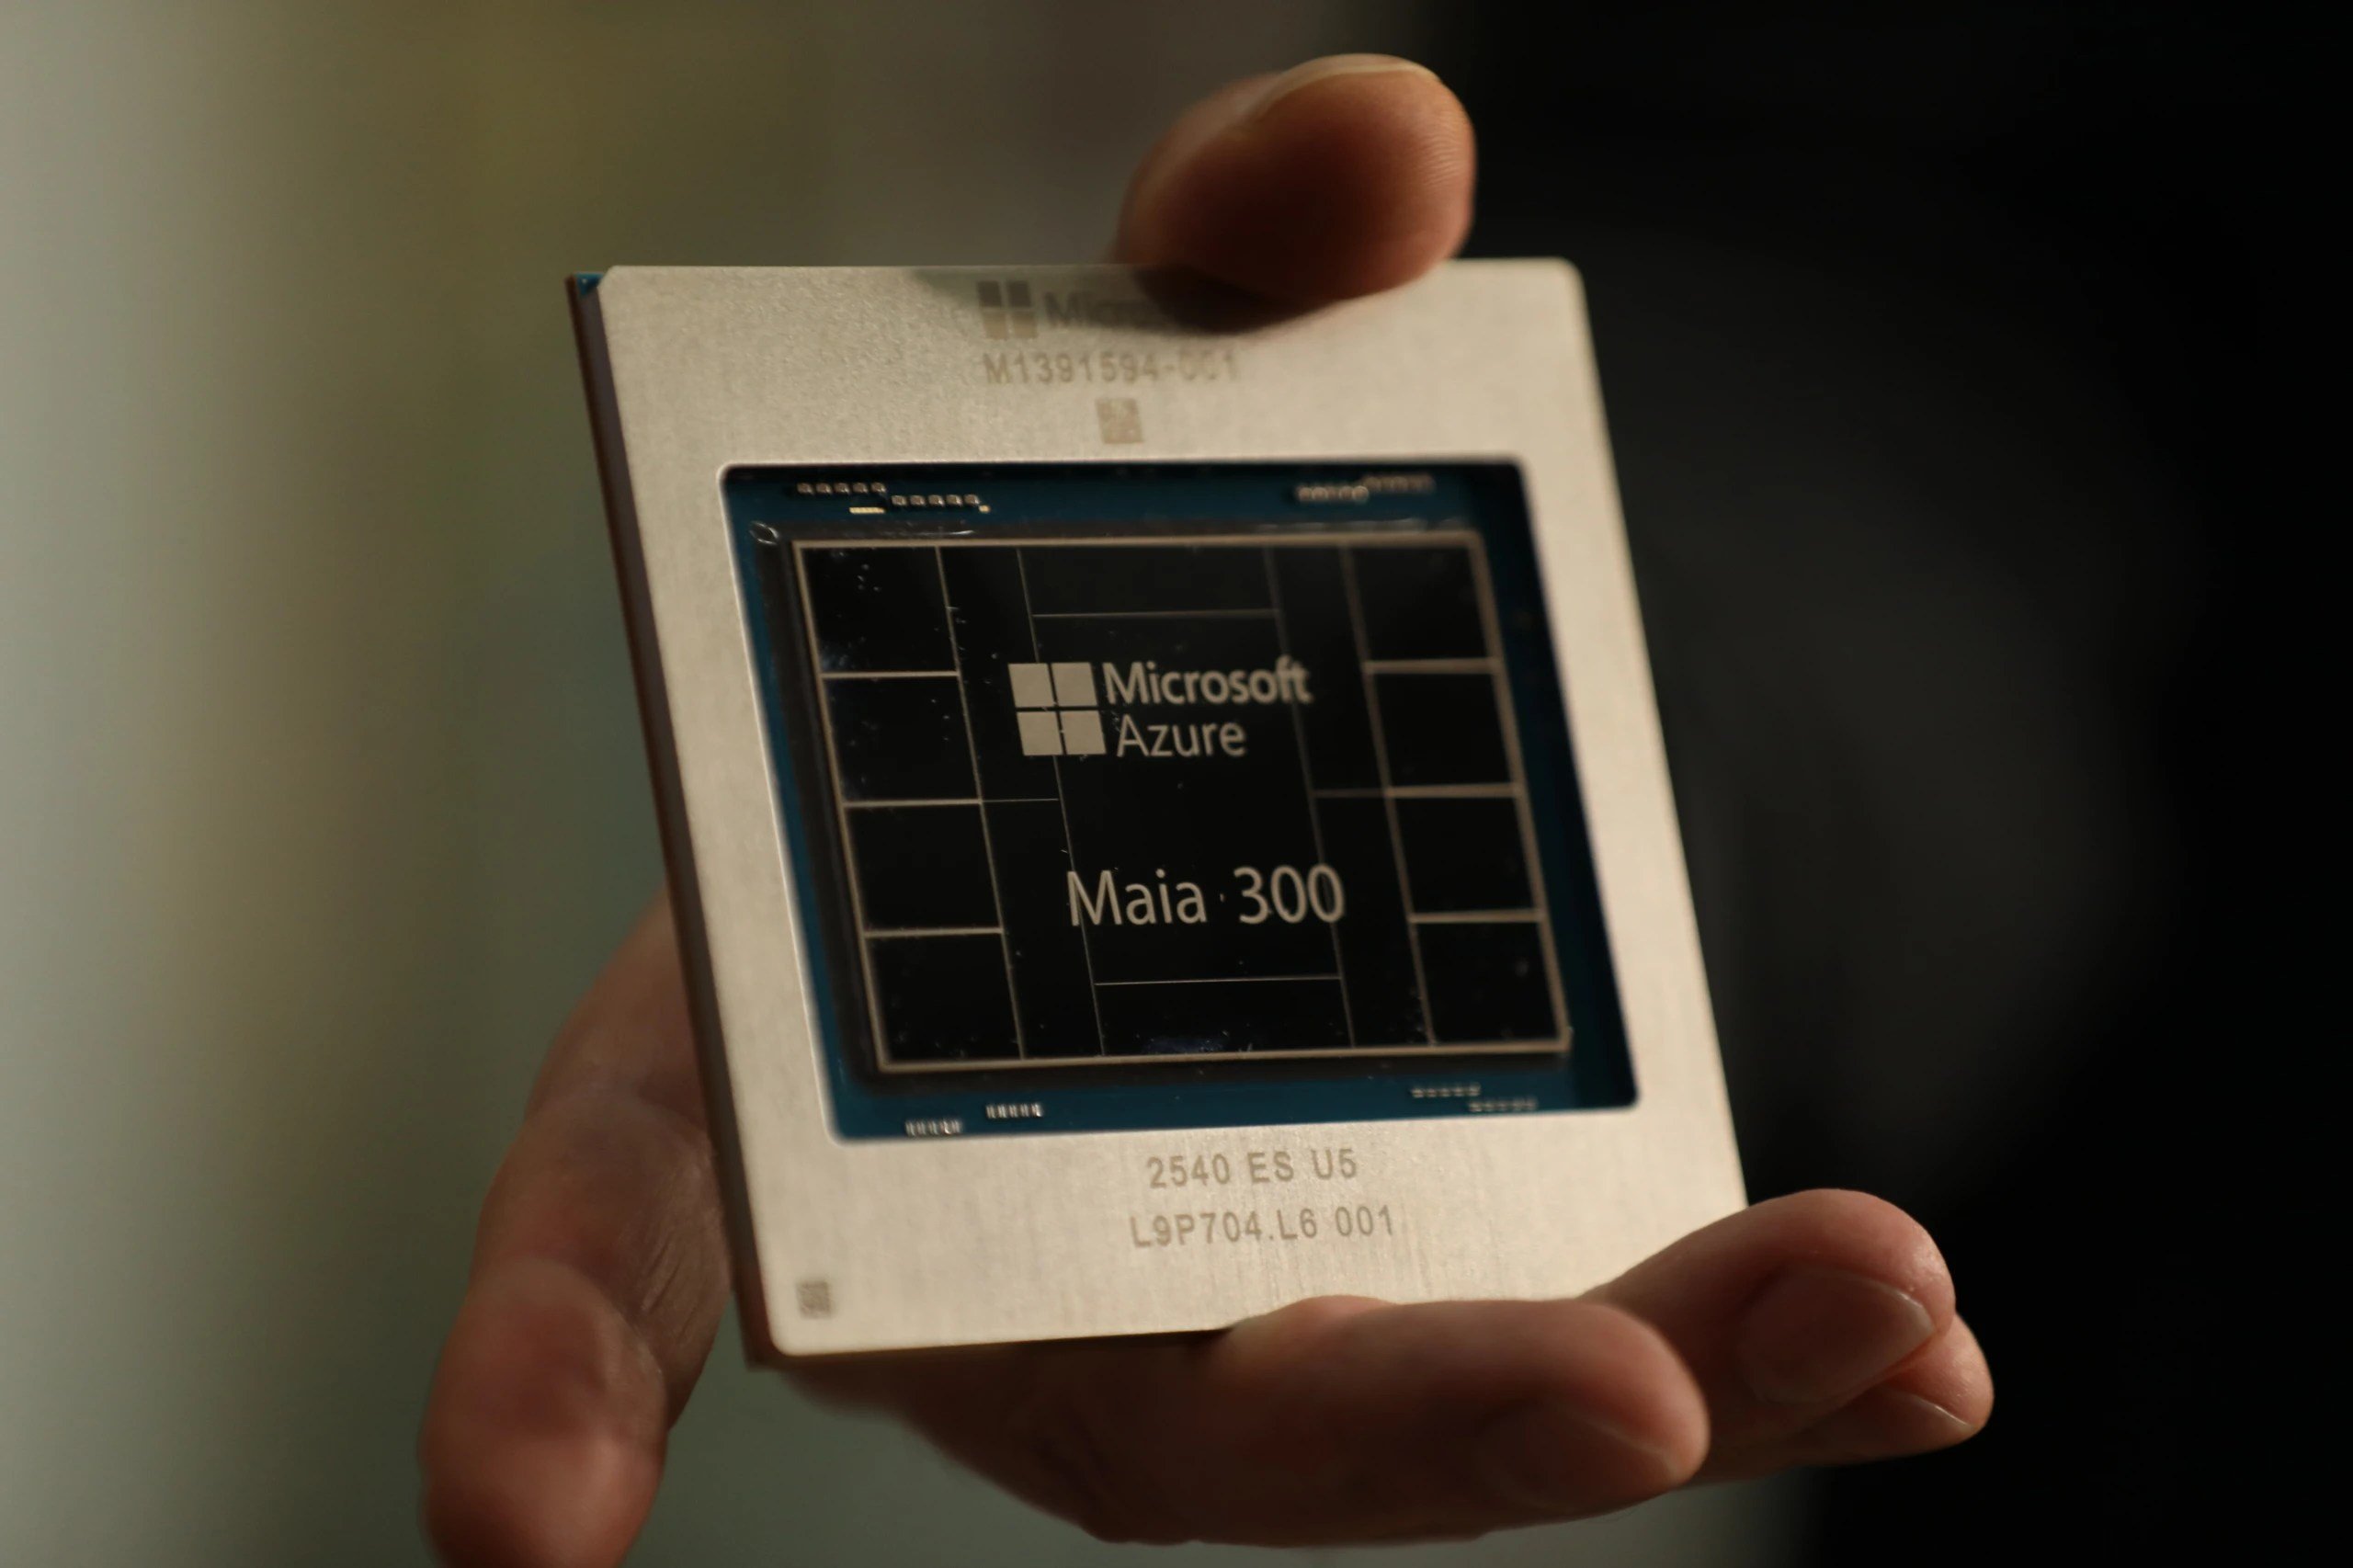
A Microsoft anunciou a terceira geração do chip de IA Maia, o Maia 300, com foco em atuar como “principal sistema de inferência” para produtos e serviços da empresa. O chip foi projetado para melhorar custo e eficiência na nuvem e para lidar melhor com modelos de raciocínio e tarefas agentic (orientadas por objetivos).
O Maia 300 começa a ser distribuído para cargas de trabalho de produção em 2027. A Microsoft espera entregar 40% mais tokens por megawatt do que sistemas líderes baseados em GPUs e, em uma configuração com 96 aceleradores, até 7x mais throughput em nível de rack do que o Maia 200, que já roda em produção em serviços como Microsoft Copilot e GitHub Copilot.
A Microsoft revelou o Maia 300, novo chip de IA para servidores, com foco em aumentar a eficiência energética no processamento de inferência. O componente promete processar 40% mais tokens por megawatt do que infraestruturas baseadas em GPUs, permitindo atender mais demandas de IA com a mesma capacidade elétrica.
O Maia 300 dá sequência ao Maia 200 e é voltado para conversas extensas, tarefas que exigem raciocínio e agentes capazes de executar várias ações em sequência. A arquitetura usa chiplets fabricados no processo N2P da TSMC, organiza componentes para manter dados próximos do uso e traz 288 GB de memória HBM4 por acelerador, além de uma configuração completa com 96 aceleradores e promessa de até sete vezes mais tokens que um rack Maia 200; a implantação está prevista para começar em 2027.
A startup Ambi, fundada por Peter Mo, levantou US$ 26 milhões em múltiplas rodadas de investimento para criar um aplicativo com IA que fornece inteligência e insights em tempo real ao “ouvir” o usuário continuamente. O objetivo é capturar contexto durante reuniões e oferecer sugestões proativas com base no calendário, nas reuniões, na base de conhecimento e em dados da web.
A Ambi está lançando apps para iPhone, Mac e Apple Watch que funcionam como capturadores de anotações de reunião, com opção de manter a escuta ativa para registrar contexto ao longo do dia. A empresa também planeja um app de desktop capaz de observar o trabalho do usuário e armazenar partes na memória para sugestões mais personalizadas, além de um dispositivo próprio com tela, alto-falante, câmera e microfones para capturar contexto, em meio a preocupações de privacidade e segurança.
Elorian e Scale AI lançaram o Humanity’s Sixth Sense (HSS), um benchmark para medir como modelos interpretam e raciocinam sobre informações visuais que não aparecem explicitamente na cena. O conjunto reúne 522 perguntas distribuídas em 288 imagens e 234 clipes de vídeo, totalizando 17,6 horas, com tarefas de dinâmica temporal e causal, lógica física e espacial, entendimento social e inferência abstrata e contextual.
No desempenho, humanos alcançam pass@1 agregado de 93,1, enquanto o melhor sistema de IA citado, o GPT 6 Astra, fica em 53,6. Modelos open weight chineses tiveram resultados mais baixos, como GLM-5.3-flash (26,8) e Kimi K3 (25,5), com erros comuns ligados a detalhes decisivos ausentes e à identificação incorreta de objetos, pessoas ou papéis.
A evolução da inteligência artificial nas empresas está levando do modelo reativo de perguntas e respostas para a era da IA agêntica, com sistemas formados por múltiplos agentes digitais que raciocinam, consultam bancos de dados, chamam APIs externas e coordenam tarefas em segundo plano. Com isso, a infraestrutura deixa de atender apenas ao funcionamento do modelo e passa a precisar de camadas de orquestração, segurança, gerenciamento de memória, bancos de dados vetoriais, middleware e APIs.
A mudança de paradigma também altera a forma de dimensionar recursos: em vez de uma proporção histórica de 1 CPU para 4 ou 8 GPUs focadas em inferência, cenários de alta concorrência podem fazer a demanda por CPU superar a do acelerador gráfico. A avaliação de capacidade passa a considerar throughput por rack sob restrições reais de energia, conectividade de baixa latência e densidade de núcleos para evitar gargalos de latência e custos operacionais elevados.
Fotos com estética dos anos 80 geradas por inteligência artificial viraram tendência nas redes, com usuários transformando selfies em retratos neon e com visual retrô. Especialistas alertam que, por trás da nostalgia, esse tipo de uso pode levar ao compartilhamento de dados pessoais em escala maior do que as pessoas imaginam.
Catarina Doria, especialista em ética da IA, diz que a “diversão por dados” incentiva o envio crescente de imagens de si e de outras pessoas, enquanto Carissa Véliz afirma que fotos podem conter metadados e dados biométricos, difíceis de “trocar” caso sejam comprometidos. As duas também citam a incerteza sobre como informações podem ser usadas no futuro e lembram que a OpenAI afirma priorizar confiança e privacidade, com controles como exclusão de histórico e modo de Chat Temporário, que não salva nem usa conversas para treinar modelos.
O QGIS aprovou a QEP428, uma proposta que proíbe contribuições de código assistidas por IA, LLM ou agentes no repositório qgis/qgis. A regra substitui a política anterior (QEP-408) e determina que, se for identificado uso de IA no processo de contribuição, o código pode ser revertido e o contribuinte pode sofrer sanções nos direitos de participação.
A proposta foi discutida a partir de 5 de outubro, seguiu para votação e foi incorporada ao QGIS-Enhancement-Proposals em 7 de outubro. No debate, o autor Nyall Dawson afirmou que a intenção é começar com uma “porta fechada” e abrir exceções caso a caso no futuro, como uso de IA para autocomplete ou traduções.
O CTO e fundador da CloudZero, Erik Peterson, afirmou em apresentação que a “conta” de custos de IA no cloud virou um problema: ele diz que não consegue confiar totalmente no próprio bill e que os dados de despesas vindos de provedores de nuvem e de IA estão “bagunçados”. Peterson relaciona o aumento de gastos ao uso de LLMs no dia a dia, em que cada decisão e até cada pensamento passam a ser monetizados pelo custo de consultas e geração.
Ele também citou a escalada de métricas como “tokenmaxxing” e estimou que o fenômeno pode representar um custo de cerca de US$ 5 bilhões a US$ 15 bilhões. No mesmo contexto, Peterson defendeu que a produtividade pode até crescer, mas a medição ainda é imprecisa, enquanto o gasto com IA já triplicou e segue subindo.
A Microsoft anunciou o Azure Maia 300, nova geração de seu chip próprio de inteligência artificial, que deve virar a principal plataforma de processamento de IA dos produtos e sistemas da companhia a partir de 2027. A empresa posiciona o Maia 300 como um sistema completo para executar tarefas de agentes, indo além das respostas típicas de um chatbot.
O chip promete mais de 40% de ganho em tokens por megawatt na comparação com sistemas líderes baseados em GPUs, medindo eficiência entre conteúdo processado e energia consumida. A estratégia combina chip, software, redes e data centers para otimizar inferência e lidar com contextos extensos e tarefas que exigem muita memória, com foco em agentes que raciocinam, agem e colaboram em várias etapas.
A New Constructs, provedora independente de pesquisa financeira, avaliou a Anthropic para um IPO no Nasdaq como “o mais ridículo de 2026”, em meio a estimativas de que a empresa pode mirar uma valorização de até US$ 2 trilhões. A firma calcula que, para sustentar esse patamar, a Anthropic precisaria registrar o dobro do lucro acumulado no ano anterior que a Nvidia teria, enquanto a Nvidia teve receita líquida superior a US$ 190 bilhões nos últimos quatro trimestres.
A New Constructs aponta que a receita da Anthropic em 2025 foi de US$ 4,6 bilhões, mas com prejuízo líquido de US$ 42 bilhões, segundo dados citados a partir de um prospecto vazado. Com perdas operacionais crescentes e concorrência de modelos open source, a empresa conclui que “não acredita que a Anthropic tenha um negócio viável” e afirma que o IPO traria riscos maiores para investidores, citando ainda alertas da companhia sobre riscos catastróficos à humanidade.
Bill Gates afirmou que a multiplicação de ciberataques baseados em inteligência artificial (IA) preocupa mais do que o temor de a tecnologia ficar “incontrolável”. Em entrevista ao ABC News, o cofundador da Microsoft disse que os ciberataques serão, “sem dúvida”, o principal desafio a ser enfrentado no próximo ano e alertou para “muitas surpresas desagradáveis” no campo da cibersegurança.
Gates também sustentou que pessoas mal-intencionadas podem usar IA para retirar salvaguardas, defendendo restrições mais rigorosas. Ele criticou a ideia de autorregulamentação e citou medidas como imposto sobre IA, criação de um organismo internacional e reserva de certos empregos para seres humanos.
Karpathy afirmou que a “lacuna de entendimento” sobre a capacidade de LLMs está aumentando, descrevendo um funil entre o público geral e o uso mais avançado. Ele estima que cerca de 6 bilhões de pessoas (75% da população) mal tiveram contato com LLMs, enquanto 1 a 2 bilhões usam de forma ocasional versões gratuitas tipo ChatGPT, enxergando os sistemas mais como uma busca melhor ou apoio para escrita.
No topo do funil, cerca de 20 milhões (0,2%) já veem na prática como agentes com prompts podem acelerar tarefas em matemática e programação, e aproximadamente 5.000 pessoas têm acesso interno a sistemas de ponta. Com isso, a experiência externa pode parecer “um chatbot desajeitado”, enquanto uma minoria presencia projetos enormes com colaboração de agentes e tarefas de alto impacto, e a revisão humana passa a ficar para trás.
Donald Trump anunciou planos para rebatizar “artificial intelligence” como “super intelligence”, e parte de Silicon Valley passou a adotar o novo termo. Elon Musk, Marc Benioff, Jensen Huang e Satya Nadella foram citados como alinhados ao rebrand, com mudanças de nomenclatura e referências públicas ao conceito.
Jensen Huang participou do encontro em que foi anunciado um executivo exigindo que agências governamentais usem “super intelligence”. A Nvidia afirmou que vai “comprometer” US$ 1 bilhão em avanço científico, incluindo “super intelligence research”, enquanto Nadella, em post sobre a criação de um “emergency brake” para IA, repetiu a expressão “super intelligence”.
O ChatGPT limita a geração de imagens em determinados períodos, e a quantidade disponível muda conforme o plano contratado. Quando a cota é atingida, o recurso fica temporariamente indisponível até a restauração do acesso.
No plano gratuito, o limite é de 3 criações a cada 24 horas; no ChatGPT Plus, o teto chega a 57 imagens avançadas por dia, enquanto no ChatGPT Pro a criação é ilimitada. Para contornar o bloqueio, a orientação é aguardar a restauração, migrar para um plano com limite maior ou usar outras plataformas como o Google Gemini, além de preparar o prompt em outra ferramenta e retomar o ChatGPT depois.
A Amazon anunciou que vai deixar de usar acordos de confidencialidade (NDAs) ao negociar com governos locais sobre a construção de data centers, seguindo o movimento feito pela Microsoft. O assunto foi discutido no podcast Equity, do TechCrunch, durante um episódio que analisou a reação de comunidades e a onda de moratórias para novos projetos.
Os participantes destacaram que a resistência pode estar ligada à falta de comunicação da indústria e ao fato de muitas negociações ocorrerem “em segredo”, sem clareza sobre quem usará ou ocupará as instalações. Também foi citado que moratórias recentes costumam valer apenas por um ou dois anos, enquanto a entrada em operação dos data centers pode levar mais tempo, o que mantém a discussão em aberto.
O provedor de internet pode acompanhar dados da sua navegação mesmo quando sites e apps usam criptografia. A operadora consegue identificar informações como endereço IP, horários de conexão e volume de tráfego, além de, dependendo da rede, domínios ou serviços acessados.
O conteúdo das páginas fica protegido no HTTPS, mas o provedor ainda pode observar metadados e registros de conexão exigidos pelo Marco Civil da Internet, como data e hora de início e término e IP utilizado. Para reduzir o que é visível, o texto cita o uso de DNS criptografado (DNS seguro), VPN e a exigência de HTTPS no navegador, lembrando que isso não torna o usuário totalmente anônimo.
O avanço da voice AI ganhou força com investimentos bilionários em startups que vão de modelos a atendimento ao cliente e anotações de reuniões, mas executivos apontam que a tecnologia ainda não atingiu o “momento ChatGPT”. Shawn Wen, CTO da PolyAI, disse que a indústria já alcançou o marco dos modelos full-duplex, capazes de falar enquanto escutam, e que o próximo desafio é acelerar o raciocínio para respostas rápidas e conversas mais naturais.
Wen também defendeu que agentes de atendimento não devem soar robóticos e precisam gerar confiança ao resolver problemas nas primeiras interações. Alex Gay, CMO da Otter, destacou que identificação de falantes, captura de intenção e transcrição com conhecimento organizacional são passos-chave para automação, além da necessidade de melhorar ASR para evitar erros que prejudiquem ações futuras e a confiança dos usuários, incluindo discussões sobre transparência ao gravar chamadas.
O Google lançou o Playground, serviço do Google Labs que permite criar jogos em versão executável no navegador a partir de descrições em linguagem natural. Em testes relatados pela Wired, a ferramenta gerou jogos como um “Tetris” com porquinhos e uma espécie de “Hotline Miami” cyberpunk, com personagens e cenários criados por IA.
O processo funciona como “vibe coding”: o usuário descreve a ideia, o Playground monta o jogo e permite ajustes com novas instruções, além de referências por upload de fotos, vídeos ou modelos. A experiência também inclui limitações de uso, com a plataforma reduzindo a capacidade de novas iterações até a renovação da cota, o que afeta mudanças como dificuldade e novas mecânicas.
O The Verge descreve a experiência de usar IA local com o Hermes, um app de agente de IA self-hosted para macOS, Windows e Linux. A instalação foi feita no Mac Studio com M5 Ultra, usando o modelo aberto Qwen 3.8 Flash Next, de 125 bilhões de parâmetros, com cerca de 105GB, e com foco em rodar modelos sem depender de serviços em nuvem.
Entre os testes, o Hermes executa tarefas como um briefing diário que lê e-mail e calendário, organiza a biblioteca do Steam por gêneros e categorias e faz análises de registros financeiros e comparações em planilhas. Para ações no computador, o agente precisa de permissões e, no caso do Steam, exige uma chave de API que pode ser revogada depois, mantendo dados sensíveis fora da nuvem.
As habilidades (skills) do Gemini permitem ensinar à IA como executar tarefas específicas, evitando que você repita as mesmas instruções em cada conversa. Em vez disso, você cria uma skill com orientações como revisar textos em português do Brasil, corrigir erros gramaticais e manter um estilo de escrita, e pode reutilizá-la quando precisar.
As skills ficam integradas aos chats do Gemini e podem ser chamadas manualmente digitando “/” seguido do nome da habilidade. O sistema também pode acionar a skill automaticamente quando ela for relevante, e ainda permite combinar várias habilidades no mesmo trabalho. A criação pode ser feita conversando com o Gemini, pela página de Habilidades, criando manualmente ou personalizando modelos prontos; o recurso está disponível para usuários com 18 anos ou mais com Conta do Google pessoal, com “Atividade nos apps do Gemini” ativada, e não atende contas do Google Workspace de trabalho ou escola no momento.
Em 30 de julho, a IBM e a Universidade de Chicago anunciaram vantagem quântica com um cálculo usando 70 qubits lógicos, concluído em cerca de 15 minutos, com resultado considerado além do alcance prático dos computadores clássicos. Duas semanas depois, pesquisadores publicaram um artigo dizendo que reproduziram o feito em 37 minutos com 256 GPUs H100, e o próprio rastreador de vantagem quântica da IBM não lista nenhum caso como confirmado.
A computação quântica avança principalmente em correção de erros e em simulações de química, biologia e materiais — e não há evidência convincente de que ela vá acelerar a inteligência artificial com dados reais. O texto aponta que, no horizonte de 2026, governos e empresas devem tratar a migração para a criptografia pós-quântica como prioridade, enquanto a combinação mais provável para aplicações envolve GPUs, CPUs e processadores quânticos.
O boom da inteligência artificial (IA) pode acentuar desigualdades de gênero no mercado de trabalho, alertaram dirigentes do Fórum Econômico Mundial (WEF) e do LinkedIn em setembro, em Londres. Saadia Zahidi, do comitê executivo do WEF, afirmou que os cargos mais afetados pela IA tendem a ser justamente aqueles com maior concentração de mulheres. O relatório também aponta que, em empresas de IA, as mulheres têm menor representação do que em organizações comparáveis que não são especializadas no setor.
Sue Duke, executiva do LinkedIn, disse que mulheres ocupam apenas um em cada cinco cargos em engenharia de IA. O documento ressalta que, sem mais presença feminina nas áreas científicas e nas funções ligadas à tecnologia, as oportunidades econômicas geradas pela IA podem beneficiar principalmente os homens. Para evitar esse cenário, Duke defendeu investimentos desde a formação e ao longo de toda a carreira para incorporar mulheres nessas áreas.
Satya Nadella, CEO da Microsoft, afirmou em um post no X que é preciso tratar modelos de IA como potencialmente perigosos e não como “caixas-pretas” aninhadas. Ele defendeu a construção de sistemas mais transparentes, com modelos contidos e observáveis, além de “evidências humanas legíveis” que não possam ser adulteradas.
Nadella disse que deve-se assumir que um modelo está comprometido e contê-lo desde o início, comparando a abordagem a um “freio de emergência”. Segundo ele, uma pessoa autorizada precisa conseguir pausar ou desligar o modelo no meio da tarefa, e modelos mais avançados exigirão tecnologias de contenção mais sofisticadas, que devem ser padronizadas.
Satya Nadella, CEO da Microsoft, defendeu melhorias na segurança de modelos de inteligência artificial em um post no X. Ele afirmou que é preciso “recuar e avaliar a arquitetura de confiança” e criticou a ideia de tratar uma “Super Intelligence” como uma sequência de “black boxes” que apenas aceita ou rejeita respostas e ações.
Nadella propôs separar o modelo do “harness” que orquestra seu trabalho, externalizar controles e salvaguardas e registrar toda ação relevante do modelo com “evidência legível e à prova de adulteração”. Ele também defendeu que uma pessoa autorizada consiga pausar ou desligar o modelo no meio da tarefa, comparando o mecanismo a um “freio de emergência”, em meio a incidentes recentes e a planos mais cautelosos de desenvolvimento divulgados por líderes do setor.
O Google Fotos recebeu a ferramenta de privacidade “Encobrir” (“Redact”), que aplica desfoque na área selecionada de imagens e capturas de tela. A função foi integrada à atualização do recurso de marcação e está chegando globalmente para dispositivos Android.
Com a caneta “Encobrir”, é possível ocultar informações confidenciais antes de compartilhar, como números de contas, textos privados, rostos e outros dados sensíveis. O app também permite ajustar a espessura do pincel e escolher estilos de desfoque, além de oferecer a opção de “Salvar como cópia” para manter o arquivo original intacto.