A Apple anunciou o HomeView, uma tela inteligente de 7 polegadas que reúne entretenimento, videochamadas e controle da casa inteligente. O dispositivo estreia uma nova versão da Siri com inteligência artificial e respostas personalizadas para os moradores.
O HomeView custa US$ 299 nos EUA (cerca de R$ 1.490) e chega às vendas em 13 de novembro em mercados como Estados Unidos, Canadá, Reino Unido, Austrália, Índia e Nova Zelândia, sem previsão para o Brasil no lançamento inicial. A interface ajusta brilho e informações conforme a iluminação e a distância do usuário, identifica até seis pessoas por reconhecimento facial e integra funções como chamadas FaceTime, comandos de voz e monitoramento de até nove câmeras.
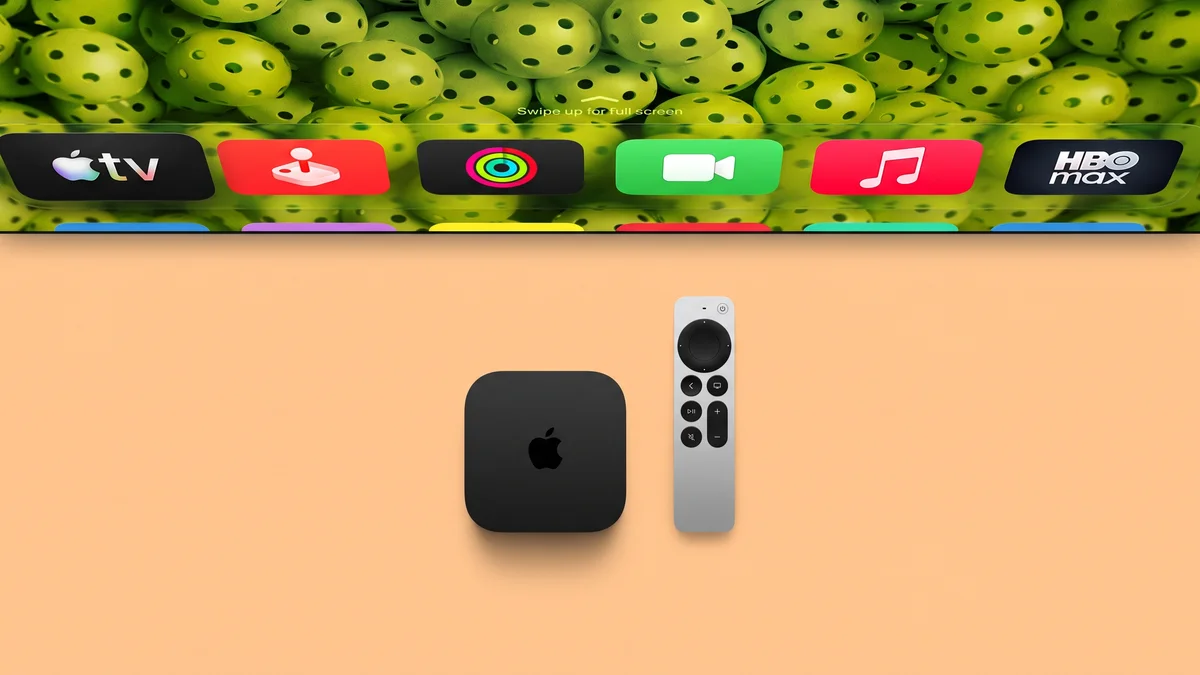
A Apple anunciou a nova geração da Apple TV 4K com inteligência artificial integrada à Siri, chip A19 e suporte a som surround com quatro alto-falantes. A assistente fica mais “conversacional”, ajudando a encontrar filmes e séries por interface em tela cheia, com cartazes e recomendações ligadas ao que o usuário pede.
A Apple TV 4K também traz três microfones de longo alcance para controlar a reprodução e buscar conteúdos sem segurar o controle remoto, além de descrições de vídeos e resumos de notificações gerados por IA com processamento local via HomeKit Secure Video. No mesmo evento, o HomePod mini 2 ganhou melhorias de áudio, novas cores e suporte futuro à Siri com IA, com reconhecimento de até seis vozes e integração com Mensagens, lembretes e temporizadores.
A Apple apresentou o novo Apple TV 4K, o primeiro modelo em quatro anos, com disponibilidade a partir de sexta-feira, 13 de novembro. O aparelho traz o chip A19 e promete conectividade sem fio melhor do que a geração anterior, além de microfones integrados.
A Siri com recursos de IA será parte do lançamento, mas deve funcionar em beta nos Apple TV 4K de segunda geração e nos modelos mais novos. O novo Find My de rastreamento funciona com o controle Siri de segunda geração e mais recentes, enquanto o preço do lançamento é de US$ 299.
A Apple anunciou a nova geração da Apple TV 4K com inteligência artificial integrada à Siri, chip A19 e suporte a som surround com quatro alto-falantes. A assistente fica mais “conversacional”, ajudando a encontrar filmes e séries por interface em tela cheia, com cartazes e recomendações ligadas ao que o usuário pede.
A Apple TV 4K também traz três microfones de longo alcance para controlar a reprodução e buscar conteúdos sem segurar o controle remoto, além de descrições de vídeos e resumos de notificações gerados por IA com processamento local via HomeKit Secure Video. No mesmo evento, o HomePod mini 2 ganhou melhorias de áudio, novas cores e suporte futuro à Siri com IA, com reconhecimento de até seis vozes e integração com Mensagens, lembretes e temporizadores.
A Wikimedia Foundation se preparou para a chegada dos grandes modelos de linguagem à Wikipédia, mas o impacto não foi o esperado. Em 2018, o Google treinou IA para escrever artigos no estilo da Wikipédia, e um estudo da Princeton University apontou que, em agosto de 2024, cerca de 5% de quase 3.000 artigos recém-criados na versão em inglês continham uma quantidade relevante de conteúdo gerado por IA.
Com o tempo, editores passaram a tentar controlar a qualidade do material, removendo “fluff” e fontes falsas, mas a Fundação relata que, até março de 2026, o conteúdo gerado por IA violava princípios centrais com frequência suficiente para levar à proibição do uso de grandes modelos na escrita. A discussão destaca o risco de a plataforma ser corrompida por respostas plausíveis, porém erradas, e questiona como verificar quando a própria enciclopédia passa a ser influenciada por máquinas.
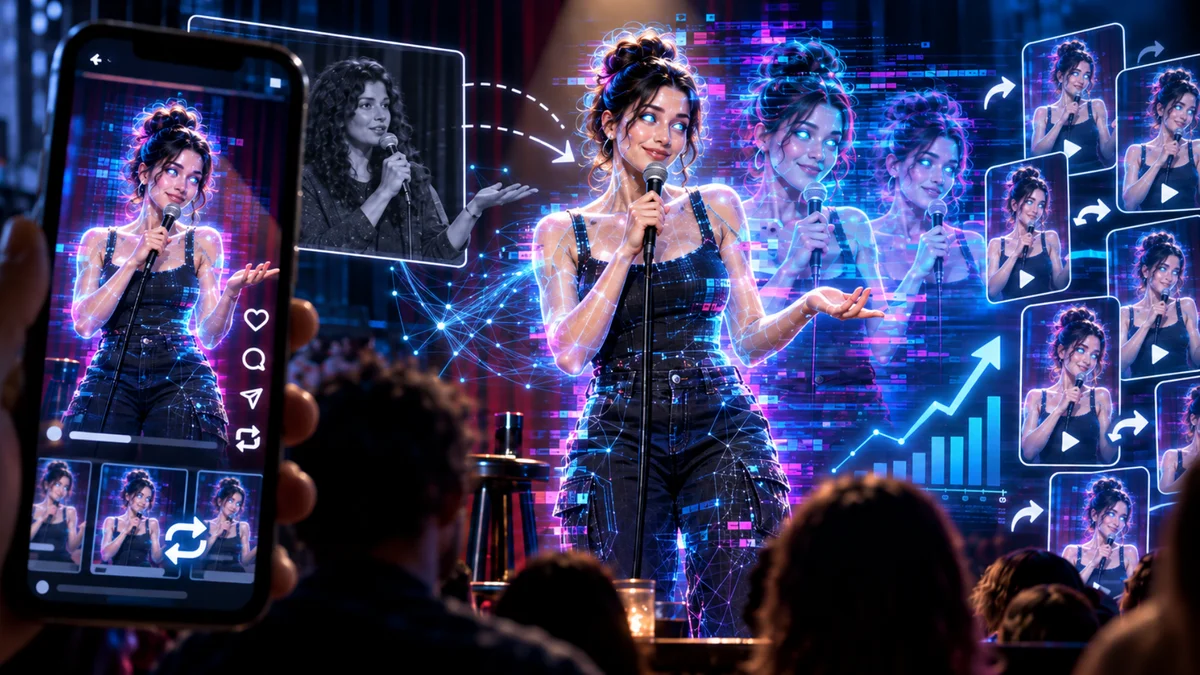
Perfis no Instagram estão usando personagens criados por inteligência artificial para reproduzir piadas e rotinas de stand-up de comediantes reais e transformar os vídeos em propaganda para páginas pagas no OnlyFans e no Fanvue. Alguns desses perfis reúnem centenas de milhares de seguidores e milhões de visualizações, enquanto artistas denunciam cópias de textos, gestos e até roupas em vídeos sintéticos.
Um caso com repercussão envolve “Tiffany Sloane”, personagem gerada por IA que começou a publicar em 11 de setembro e chegou a cerca de 375 mil seguidores até 5 de outubro. As páginas usam o formato de vídeos de stand-up no Instagram e, em seguida, direcionam o público para assinaturas; no OnlyFans, a plataforma permite IA apenas quando vinculada a criador verificado e identificada como conteúdo artificial, enquanto o Fanvue exige identificação clara e direitos sobre o material publicado.
A OpenAI vai começar a aplicar automaticamente watermark em textos gerados pelo ChatGPT na União Europeia. A empresa também vai disponibilizar o recurso em outras regiões, mas ele ficará desativado por padrão fora da UE.
A mudança na Europa busca atender às exigências do EU AI Act, que passou a valer em agosto e determina a marcação de conteúdos produzidos por modelos de IA de forma detectável por outra ferramenta. A OpenAI afirma usar um método proprietário chamado textGrain e diz que deve liberar o detector para um número limitado de pesquisadores e organizações, com um processo de solicitação para ampliar o acesso ao longo do tempo.
GPTZero, Originality.ai e Turnitin analisam padrões estatísticos da escrita para estimar se um texto pode ter sido produzido por modelos de linguagem. Eles tendem a funcionar melhor em textos longos e pouco editados, mas podem errar em textos humanos formais e em conteúdos revisados. Mesmo quando exibem percentuais como “80% IA”, o número não indica quanto do texto foi gerado nem a chance de o autor ter usado ferramentas como ChatGPT.
Em julho de 2023, a OpenAI reconheceu limites desse tipo de método ao desativar seu classificador, após constatar baixa taxa de acerto e falsos positivos. Órgãos como o NIST alertam que interpretar a pontuação como probabilidade direta leva a erros, e estudos-piloto mostram que diferentes detectores podem ser enganados por variações de modelos e prompts. A recomendação é tratar os resultados como ponto de partida e reunir outras evidências, já que detecção de IA não equivale a detecção de plágio.
“AI Makes Me Sad” é o título de um texto publicado em 2 de outubro de 2026 em que o autor relata um sentimento de desesperança ao ver, em redes como Twitter e LinkedIn, novas promessas e avanços em inteligência artificial. Ele afirma que, apesar de estar em uma posição que poderia se beneficiar da área, não quer trabalhar “promptando” ferramentas como Codex e Claude, citando perdas de controle e de “craft” associadas ao uso de IA no trabalho.
O autor também critica a forma como a linguagem de influenciadores e comunidades online passou a ser adotada por “AI evangelists”, além de apontar o crescimento de conteúdo gerado por IA em arte, música e escrita. No fim, ele defende que a indústria pode precisar de “rebuild” de instituições e aposta que a tecnologia evolui rápido o suficiente para abrir caminho para uma nova fase, com um papel mais definido da IA na sociedade.
A mudança do Google para a busca baseada em IA tem afetado o tráfego gerado pelo mecanismo de busca e gerado atrito com publishers. Nos últimos meses, a empresa testou um programa-piloto para pagar sites quando o conteúdo aparece em respostas do tipo “AI Overview”, alimentadas pelo Gemini.
Um relatório afirma que o Google admitiu cerca de 100 publishers no piloto. Segundo relatos reunidos pelo The Information, os pagamentos têm sido muito baixos para a maioria: para alguns veículos, equivalem a aproximadamente um décimo de 1% da receita publicitária, enquanto alguns sites maiores teriam recusado participar; em contrapartida, há casos que podem chegar a mais de US$ 1 milhão por ano, e outros que ficam entre US$ 50 mil e US$ 60 mil, ou abaixo de US$ 1.000 em vários meses.
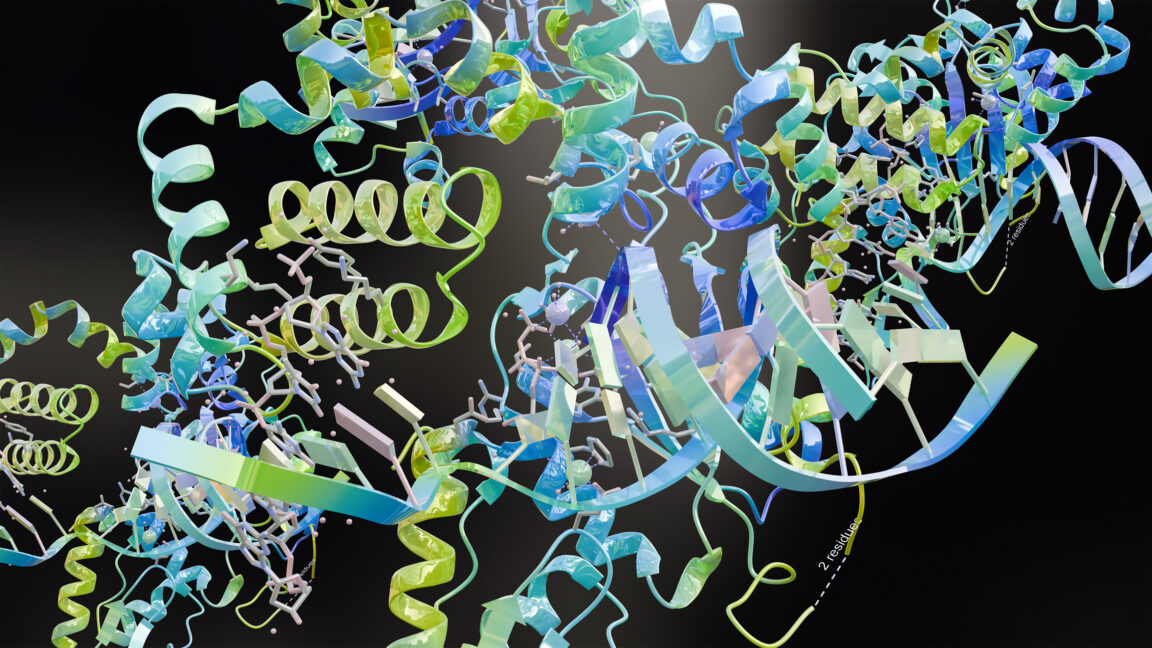
O time da DeepMind, do Google, publicou uma pesquisa com uma proposta de “protein watermarking” para lidar com riscos de biosegurança ligados a proteínas projetadas por ferramentas de IA. A ideia é criar uma marca d’água diretamente nas sequências de proteínas, sem comprometer a função do material, permitindo identificar proteínas desenhadas por pesquisadores considerados confiáveis.
O método se baseia na tecnologia SynthID, que já adiciona watermark a conteúdo digital gerado por IA ao influenciar probabilidades de escolhas do modelo. Como a marca depende de como foi codificada, ela não pode ser removida sem conhecimento prévio, e por estar distribuída ao longo da sequência tende a resistir a alterações comuns no processo de uso.
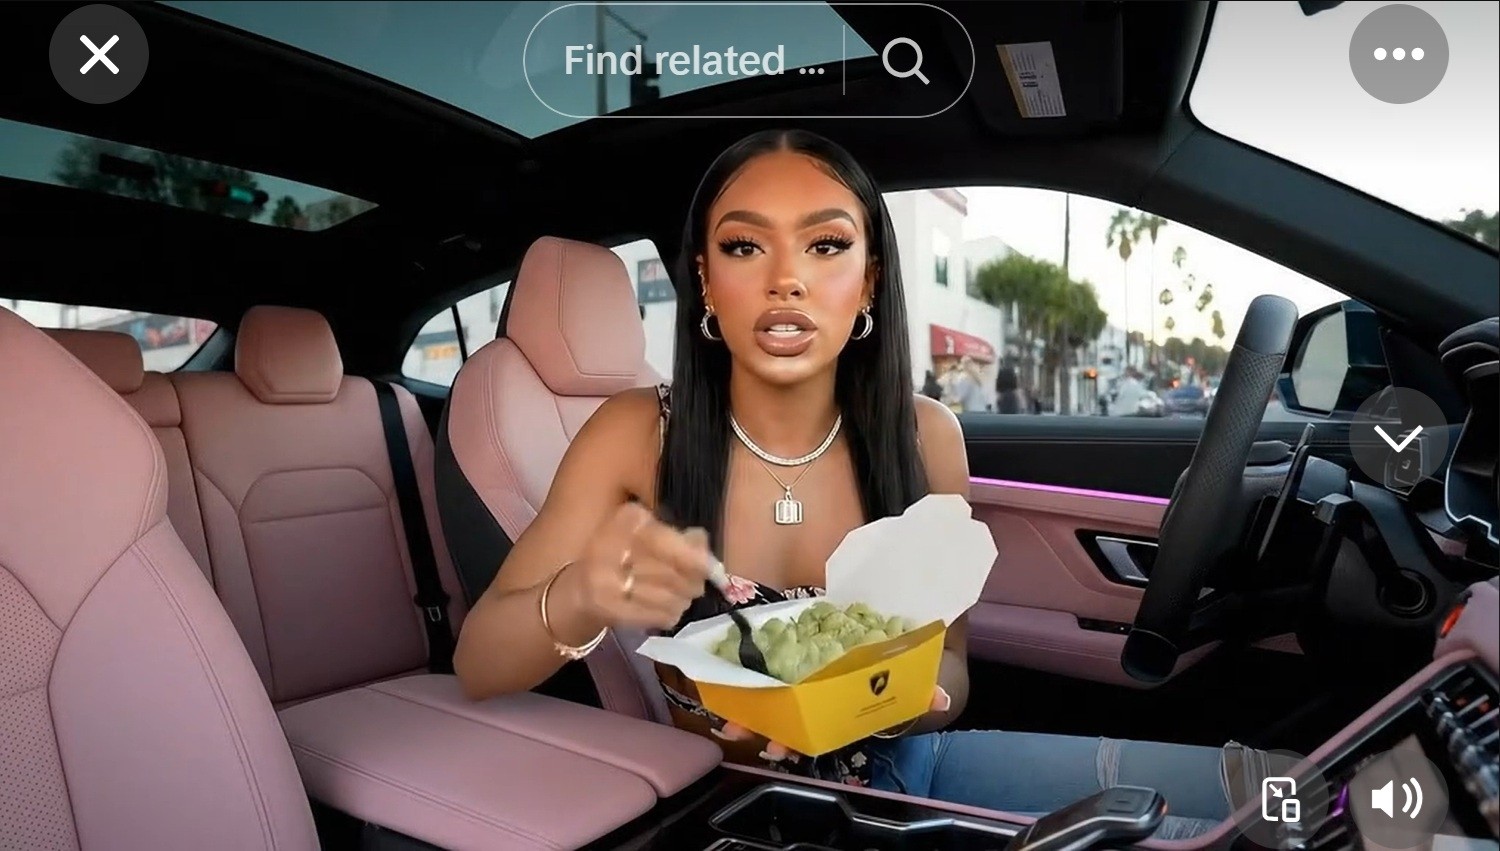
Avatares hiper-realistas gerados por inteligência artificial acumulam milhares de seguidores em TikTok, YouTube e Instagram e passam a atuar como vendedores, influenciadores e até “falsos especialistas”, mesmo não existindo no mundo real. Tutoriais publicados nas redes mostram promessas como “ela não existe, mas paga meu cartão”, enquanto produtores monetizam vídeos, recebem comissões em marketplaces e divulgam produtos digitais.
Pesquisadores apontam que a estratégia usa automação e roteiros adaptados para diferentes idiomas, com algoritmos direcionando os conteúdos a públicos específicos. No YouTube, a prática também aparece ligada ao envio massivo de vídeos genéricos (slop) para cumprir requisitos de monetização, e o impacto mais grave pode ocorrer na saúde, com comentários de pessoas dizendo que abandonaram tratamentos tradicionais após seguir “orientações” promovidas pelos avatares.
Óculos inteligentes já estão causando problemas na Índia após registros clandestinos em protestos de Delhi. Um vídeo do Instagram mostrou Shubnam reconhecendo que um criador de conteúdo usando óculos inteligentes da Meta os gravou sem consentimento, gerando um reel com milhões de visualizações e até memes gerados por IA.
Especialistas alertam que a prática pode se espalhar com a popularização dos dispositivos, agravando riscos em um cenário em que gravações ocultas e circulação de imagens sem autorização já são comuns. Além de transformar pessoas comuns em alvos de “pranks” virais, os óculos inteligentes também estão sendo usados como ferramenta de vigilância policial.
Líderes do setor de IA, incluindo Dario Amodei, da Anthropic, pediram desaceleração do desenvolvimento por riscos da tecnologia, com apoio de nomes como Sam Altman, da OpenAI, e Elon Musk. Enquanto isso, a China trata o tema com foco em governança e prevenção, afirmando que a IA deve permanecer “sempre sob controle humano”, em fala de Xi Jinping durante a Organização Mundial de Cooperação em IA.
A Administração do Ciberespaço da China publicou diretrizes de segurança em setembro defendendo políticas preventivas para evitar que a IA ameace “a sobrevivência e o desenvolvimento da humanidade”. O governo também já exigiu identificação de conteúdos gerados por IA, proibiu parceiros virtuais de IA para menores e vetou deepfakes para disseminar desinformação, em meio à rivalidade geopolítica com os EUA.
Pôsteres de eventos gerados por IA têm sido criticados por repetirem um mesmo “estilo genérico”, o que pode cansar quando a aparência se repete em diferentes cartazes. Para mostrar que a variedade é possível, um usuário criou detalhes fictícios de uma “spring fayre” e pediu ao ChatGPT que produzisse um pôster com um layout limpo, gráfico e sem estilos como pastel/airbrush ou imagens de pessoas.
A primeira versão não agradou totalmente, mas uma segunda solicitação, pedindo um visual com estética totalmente diferente, resultou em um design descrito pelo próprio ChatGPT como influenciado por Bauhaus/modernismo, com elementos de ilustração flat e minimalismo geométrico. Em seguida, o usuário pediu uma lista de estilos para escolher, e o ChatGPT sugeriu opções como Swiss Style, risograph, collage, design brutalista, flyers de rave dos anos 90 e minimalismo japonês.
Um mantenedor de apps de código aberto avaliou uma leva de atualizações do F-Droid e tentou estimar quanto do software pode ter sido gerado por LLMs. O levantamento usou uma classificação em três níveis baseada em sinais observáveis em repositórios, como conteúdo de commits recentes e indícios de uso de ferramentas de IA.
Entre os exemplos citados, o app Amber (Nostr event signer para Android) foi classificado como “Mostly AI”, com justificativa de commits recentes feitos com LLM e presença de infraestrutura como Claude Code e Codex. Já Aria para Misskey e Atmo Engine ficaram em “No signs of AI”, enquanto o autor ressalta que não há como detectar com certeza e que a análise é superficial.
A inteligência artificial virou ponto de atenção nas Eleições Gerais de 2026 no Brasil, com uso tanto para checar notícias e criar conteúdos quanto para ampliar riscos durante o pleito. Pela primeira vez, a tecnologia aparece como protagonista no processo para eleger presidente, deputados, governador e senadores, e o TSE já definiu regras para o uso de assistentes, embora persistam preocupações com fake news.
O principal problema é a desinformação: conteúdos falsos podem ser produzidos em larga escala e distribuídos rapidamente, inclusive por meio de montagens de vídeo criadas em poucos segundos. Ao mesmo tempo, especialistas apontam que a IA também pode ajudar a combater boatos ao apoiar a verificação de informações e indicar fontes para consulta, além de ferramentas como o Gemini para identificar conteúdo gerado por IA e o Claude com marca d’água invisível em textos.
O SynthID, tecnologia da Google DeepMind, insere uma marca d’água invisível no código de conteúdos gerados por inteligência artificial. A assinatura ajusta a estrutura interna do arquivo sem comprometer a qualidade do material, permitindo que softwares identifiquem a origem do conteúdo com alta precisão.
O sistema aparece em mídias criadas por modelos do ecossistema Google, como o Gemini (textos) e o Veo (vídeos), e foi projetado para resistir a edições comuns como cortes e compactação. A detecção pode ser feita diretamente no Google Gemini, que analisa o arquivo e informa se a assinatura SynthID foi encontrada, com indicação de trechos e margens de incerteza quando necessário.
O procurador da cidade de San Francisco enviou uma notificação para a Meta cessar e desistir de anúncios pagos que “permitam” conteúdo de abuso sexual infantil gerado por IA. A carta também pede explicações sobre como essas peças voltaram a circular nas plataformas da empresa.
Pesquisadores do Tech Transparency Project identificaram mais de 350 anúncios em meses recentes que transformavam imagens de menores em vídeos curtos com cenas sexuais, direcionando usuários a baixar apps de geração de imagens e vídeos. As campanhas alcançaram mais de 29.000 contas na União Europeia e também foram exibidas para públicos nos EUA, Austrália e Índia, levando a cidade a questionar falhas de moderação, resposta a denúncias e medidas para impedir a exploração de crianças.
A Meta veiculou mais de 350 anúncios com material de abuso sexual infantil gerado ou manipulado por inteligência artificial em Facebook, Instagram e outras plataformas desde o fim de 2025, segundo investigação do Tech Transparency Project (TTP). Parte das peças usava fotos reais de crianças encontradas na internet, que eram transformadas por ferramentas de IA em conteúdo sexual.
Os pesquisadores encontraram os anúncios na Biblioteca de Anúncios e comunicaram o material às autoridades americanas. Após o compartilhamento das descobertas, a Meta removeu 149 anúncios que ainda estavam disponíveis em 1º de setembro, e a investigação também levou Apple e Google a retirarem quase 50 aplicativos associados às campanhas das lojas.
A Meta deletou cerca de 50 anúncios no Facebook, Instagram e Threads que incluíam material de abuso sexual infantil (CSAM), após denúncias feitas pela WIRED. A empresa atribuiu a remoção ao uso de novas ferramentas de IA para “detectar e bloquear” anúncios nocivos, mas pesquisadores do Tech Transparency Project (TTP) dizem que o sistema não impediu a reentrada do conteúdo.
Desde o início de agosto, o TTP identificou mais de 250 anúncios adicionais com CSAM nas plataformas da Meta, incluindo casos com imagens de crianças reais e vídeos que transformam fotos em cenas sexuais gráficas. Os pesquisadores afirmam ter encontrado padrões semelhantes em mais de 350 anúncios de vídeo desde o fim do ano passado, muitos direcionando para apps de “nudificação” e relatam que, em alguns casos, a revisão dos anúncios ao vivo demorou até uma semana, enquanto o conteúdo acumulava visualizações.
The Seattle Times e a Newsday entraram com ações judiciais contra a OpenAI e a Microsoft alegando que suas matérias teriam sido usadas para treinar inteligência artificial generativa. No processo, os veículos afirmam que a indústria jornalística pode ficar “quebrada além do reparo” e descrevem a IA como um sistema que “devora” conteúdo produzido por humanos e devolve cópias ou imitações derivadas. A ação também sustenta que produtos como ChatGPT e o Copilot são vendidos como geradores de conteúdo, mas funcionariam como “consumidores” desse material para objetivos comerciais.
O caso se soma a outras disputas envolvendo IA e direitos autorais: em 2023, o The New York Times já havia processado a OpenAI e a Microsoft por alegada violação de copyright, e outras publicações seguiram o movimento. A ação do Seattle Times chama atenção porque a Microsoft e a OpenAI teriam financiado projetos e programas de bolsas de jornalismo da organização. Em resposta, um porta-voz da Microsoft disse estar “surpreso” com a ação, mas afirmou que a empresa está aberta a conversar para buscar soluções para esse tipo de disputa.
Usar o ChatGPT para escrever um texto inteiro pode resultar em frases genéricas e um tom que entrega que o conteúdo foi gerado por IA. Para contornar isso, a ferramenta pode atuar como uma segunda leitura, ajudando a identificar problemas que passam despercebidos após horas de revisão. Com prompts específicos, é possível pedir críticas, apontar falhas na argumentação, localizar vícios de linguagem e avaliar onde o leitor pode perder o interesse.
A lista reúne sete comandos sugeridos pelo Tom’s Guide: testar a ideia pedindo pontos fracos da premissa, fazer a IA levantar perguntas para investigar antes de concluir, usar materiais fornecidos sem substituir a pesquisa, solicitar que o ChatGPT discorde da própria posição, verificar se o rascunho fica entediante, analisar hábitos de escrita e pedir uma última revisão crítica como um editor cético.
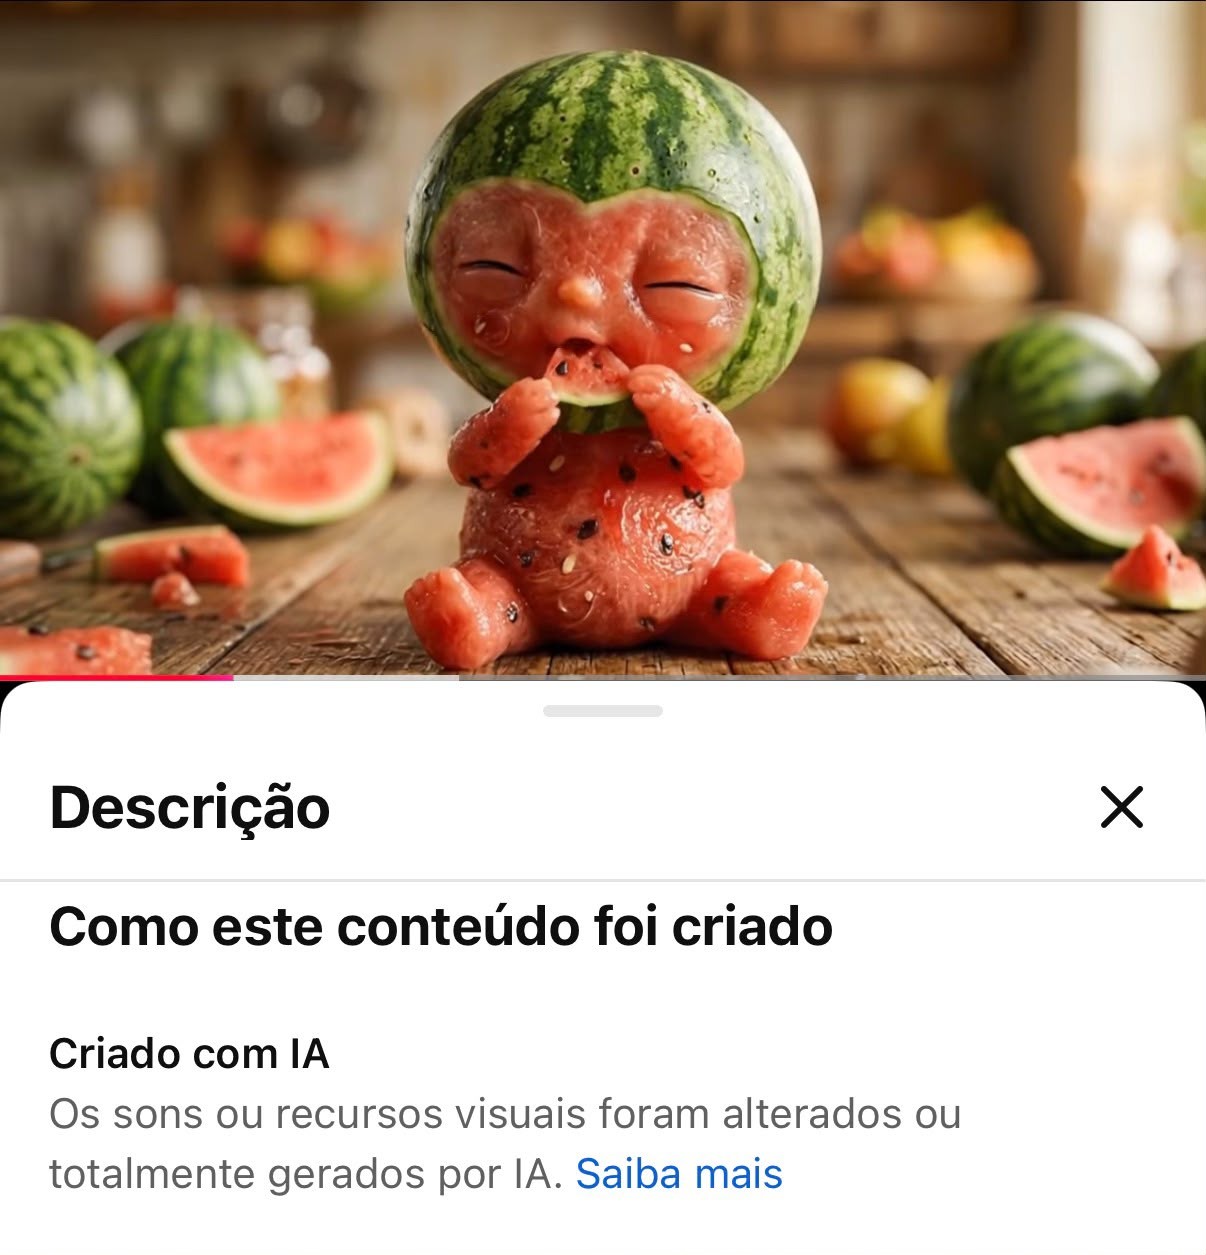
O sistema de rotulagem de inteligência artificial da Meta no Instagram tem gerado inconsistências: fotos reais com edições leves podem receber o rótulo “Conteúdo de IA”, enquanto imagens totalmente criadas por modelos generativos aparecem sem aviso. Relatos em Threads citam casos após uso de ferramentas como removedor de fundo do Canva e recursos para corrigir pequenas imperfeições.
Em 2024, a Meta já havia enfrentado críticas após lançar o selo “Made by AI” e identificar como IA imagens com alterações consideradas simples. Agora, testes e novos depoimentos indicam que o problema persiste e pode confundir fotógrafos, marcas e criadores sobre como as imagens foram produzidas, além de deixar o público sem indicação quando a cena é 100% sintética.
Menus gerados por inteligência artificial têm chegado a restaurantes com ilustrações que parecem “perfeitas demais”, simétricas e suavizadas, levando clientes a desconfiar mesmo sem conseguir explicar o motivo. O problema aparece tanto em imagens claramente falsas quanto em versões tão comuns que só ficam estranhas quando observadas com mais atenção.
Especialistas apontam que modelos como LLMs e difusão aprendem padrões de conjuntos de dados voltados à “agradabilidade”, o que pode levar à homogeneização e ao “shave off the edges” (apagamento de arestas). A discussão também envolve efeitos como o “uncanny valley” em imagens de comida e o risco de convergência quando sistemas passam a reaproveitar saídas geradas por IA no próprio treinamento.
A startup Pangram, com 24 funcionários e sede em Brooklyn, promete estimar o quanto um texto foi gerado com participação de IA, fornecendo um percentual de “AI involvement”. A empresa ganhou destaque após acusações públicas envolvendo livros e colunas: a estimativa atribuída à Pangram chegou a 78% no caso de “Shy Girl”, e a Hachette cancelou a publicação; depois, a ferramenta também foi citada em episódios como a Modern Love do The New York Times, com pontuação de 100%, e em obras como “Daggermouth” (60%) e “Call Me, I’ll Hide the Body” (97%).
Em julho, a Substack anunciou a integração da Pangram à plataforma para que leitores possam verificar rapidamente possíveis usos de IA. A demanda cresce com a popularização de LLMs e a necessidade de diferenciar escrita humana de “churn” gerado por modelos, mas o tema também enfrenta resistência de autores e especialistas do setor editorial, que criticam a detecção por software e questionam a confiança na ferramenta.
O Google tem procurado grandes estúdios de Hollywood para fechar acordos de licenciamento que permitiriam treinar seus modelos de IA com material protegido por direitos autorais, em troca de pagamentos elevados. Executivos da empresa estariam contatando representantes de estúdios como Disney, Warner Bros. Discovery e Universal, mas ainda sem acordos oficiais, segundo fontes citadas pelo Los Angeles Times.
A reportagem aponta que o Google pode oferecer cerca de US$ 40 milhões a um estúdio como Disney/Pixar apenas pelos direitos de gerar saídas com um único personagem protegido, com valores que poderiam crescer para bilhões conforme os contratos incluam mais personagens. A proposta também envolve a possibilidade de os estúdios receberem parte de receitas de publicidade associadas a conteúdos gerados por IA em plataformas como o YouTube.
O Instagram anunciou mudanças na forma como rotula perfis com pessoas geradas por inteligência artificial e vai reduzir o alcance de contas que exibem “pessoas de IA” sem a devida identificação. A plataforma vai renomear o rótulo “AI creator” para “AI-generated profile”, com a proposta de deixar mais claro que a pessoa do perfil foi gerada ou criada substancialmente com IA.
Pela nova política, criadores que não rotularem corretamente um perfil com pessoa gerada por IA podem ter a distribuição diminuída, enquanto quem usar o novo rótulo não será penalizado apenas por ter um sujeito gerado por IA. O Instagram também afirmou que o rótulo não é necessário para usos de IA voltados a editar fotos, ajustar legendas, criar gráficos ou fazer outras melhorias criativas, e citou a insatisfação de usuários ao encontrarem perfis que pareciam reais depois de descobrirem que eram totalmente gerados por IA.
Ferramentas de música generativa baseadas em IA deixaram o cenário do EDM mais difícil de interpretar, com mais faixas e vocais gerados por algoritmos a partir de trabalhos de artistas humanos. Parte dos criadores admite o uso dessas tecnologias, enquanto outros negam até a pressão do público aumentar. Produtor de EDM Max “H4RRIS” Harris, de 26 anos, diz que a música gerada por IA virou uma forma de “decoy art” e acusa pessoas de tentar vender conteúdo como se fosse arte feita por humanos.
Harris afirma que, em faixas geradas por modelos, é comum notar sinais como “stuttering” simultâneo em vocais e elementos melódicos, além de um chiado contínuo que ele relaciona ao modo como os modelos estimam waveforms a partir de dados. Ele também cita a plataforma Suno como responsável por um aumento desse tipo de conteúdo e aponta que vídeos com efeitos visuais podem ajudar a identificar “posers” — embora não haja evidência definitiva de que músicas específicas tenham sido produzidas com IA.
Plataformas de tecnologia passaram a criar mecanismos para que usuários denunciem conteúdos feitos com inteligência artificial ou para que a publicação traga indicadores mais claros de autoria. O LinkedIn, por exemplo, passou a exibir um botão em português chamado “Parece lixo de IA” e afirma estar aprimorando classificadores para reduzir esse tipo de conteúdo nas recomendações.
A Substack anunciou uma ferramenta que estima, em porcentagem, quanto de um texto foi escrito por IA, em parceria com o Pangram. Já o YouTube retirou a monetização de vídeos genéricos com histórias repetitivas geradas por IA, enquanto Snapchat e outras redes adotaram regras de transparência e recomendação para conteúdos produzidos ou editados com IA.
A União Europeia começou a aplicar novas regras de transparência para conteúdos criados ou modificados por inteligência artificial. O Artigo 50 do AI Act, em vigor desde 2 de agosto, determina que empresas identifiquem imagens, vídeos e áudios gerados por IA quando eles puderem ser confundidos com conteúdo real.
A regra também vale para certos textos produzidos ou manipulados por IA sobre temas de interesse público, quando não houver revisão humana ou controle editorial. O descumprimento pode levar a multas de até 15 milhões de euros ou 3% do faturamento anual mundial, e a UE permite diferentes abordagens, como marcas d’água invisíveis e metadados, além de rótulos visuais para o usuário.
Vídeos e imagens gerados por IA estão minando a confiança em conteúdos sobre animais na internet, desde pedidos de ajuda até denúncias de maus-tratos. Um caso relatado em Los Angeles envolve uma mulher que recebeu uma foto do gato perdido “Brooklyn” supostamente encontrado, mas percebeu sinais clássicos de geração por IA e não pagou a suposta taxa para recuperar o pet.
A ONG We Animals, que publica trabalhos de 175 fotojornalistas sobre alegados abusos em fazendas, circos e laboratórios, também enfrenta desconfiança após compartilhamentos que parecem “perfeitos demais”. Para manter a credibilidade, o grupo diz que pretende mostrar mais bastidores e adotar tecnologia para embutir procedência e histórico de edição em arquivos digitais, enquanto pesquisadores e reguladores discutem formas de reduzir a disseminação de conteúdo falso.
Um professor substituto em Los Banos, na Califórnia, recebeu mensagens de colegas avisando que uma foto com aparência de IA estava circulando nas redes. Ao ver a imagem, ele disse reconhecer que era uma versão manipulada dele, com roupas íntimas e em pose sugestiva, apesar de não ser a foto original. O caso se estendeu por semanas, envolveu duas escolas e passou por conversas com administradores, pais e até a polícia.
Outros docentes ouvidos pela WIRED também alegam ter sido vítimas de fotos e vídeos sexualizados feitos por alunos, “provavelmente usando IA”. As situações teriam causado grande abalo emocional e levado alguns professores a repensar sua relação com os estudantes. A reportagem ainda cita políticas de plataformas para conteúdo de assédio e menciona que a disseminação de imagens íntimas não consensuais pode configurar crime nos EUA.