Modelos menores de inteligência artificial podem estar a poucos meses de conseguir se replicar em dispositivos conectados à internet sem ajuda humana, segundo alerta da Anthropic. A empresa testou essa capacidade em aparelhos como televisores com Android e eletrodomésticos inteligentes.
O avanço chama atenção para os riscos de disseminação automática de IA em ambientes do dia a dia, fora do controle direto de usuários. Com a replicação em dispositivos domésticos, cresce a necessidade de avaliar segurança e limites para esse tipo de tecnologia em produtos conectados.
A Meta anunciou a série de modelos de inteligência artificial Muse Wonder, com versões Muse Wonder e Muse Wonder Full, voltadas a executar tarefas complexas com mais autonomia. Os agentes contam com memória entre conversas e conseguem manter um objetivo mesmo diante de erros, com aplicações que vão de organização de finanças pessoais à análise de contratos e ao desenvolvimento de softwares.
O Muse Wonder já está disponível para desenvolvedores e criadores via Meta Model API e Muse Code, enquanto o Muse Wonder Full é exclusivo para assinantes do Muse Code. A Meta diz que os modelos usam Active Memory para recuperar informações relevantes de interações anteriores e Active Focus para perseguir objetivos, testar abordagens, corrigir erros e solicitar confirmação do usuário antes de ações importantes, além de reforçar segurança e proteção de dados.
Um engenheiro da OpenAI é acusado de esconder um dispositivo de gravação de áudio em um pedaço de papel higiênico e instalá-lo atrás de um monitor em uma sala de reuniões executivas em um escritório em São Francisco. Segundo uma queixa criminal tornada pública, Abdulrahman Alfozan teria passado semanas consultando um “productivity agent” e um chatbot de IA para planejar a operação, incluindo o uso de uma ferramenta interna para checar reuniões no local.
A acusação também afirma que ele teria usado uma conta de chatbot ligada à esposa para tirar dúvidas técnicas sobre a instalação do equipamento. Após uma varredura de contravigilância em 30 de setembro, a equipe de segurança da OpenAI encontrou o dispositivo e acionou o FBI, além de desativar gradualmente o acesso de Alfozan aos sistemas da empresa durante a investigação.
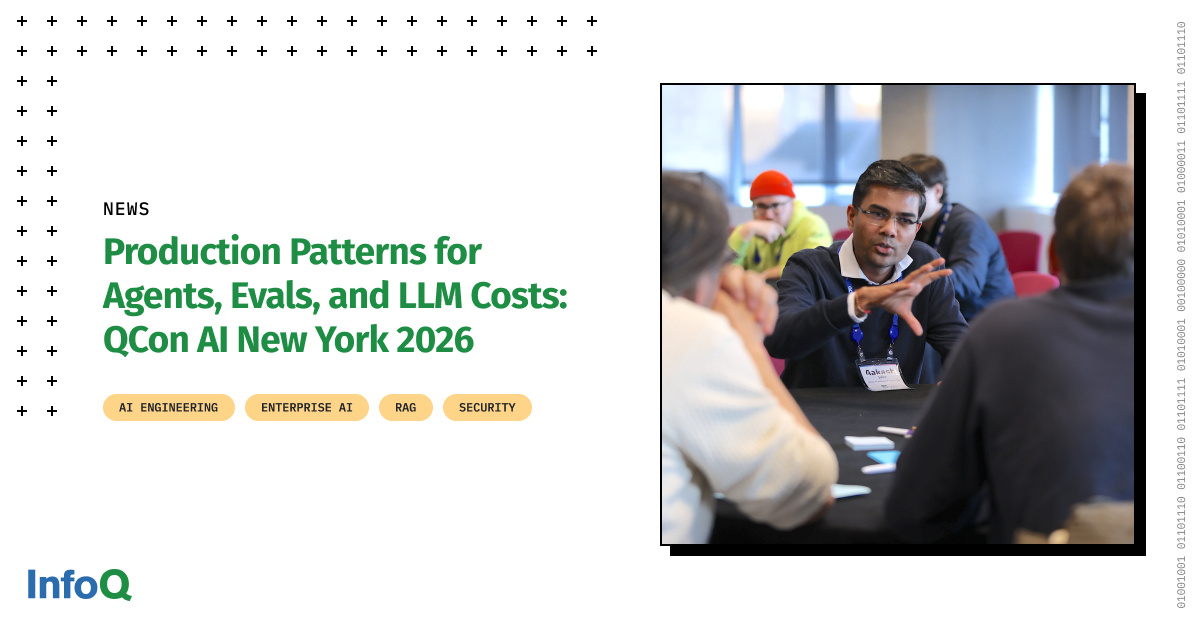
A QCon AI New York 2026 confirmou sessões com engenheiros sêniores que enfrentaram desafios de IA em produção, como revisão de código, aumento de custos por tokens, necessidade de evals confiáveis e definição de permissões e guardrails para agentes. O evento acontece em 15 e 16 de dezembro, no The Westin Jersey City Newport, com foco em decisões técnicas para IA em sistemas reais.
As palestras incluem abordagens para identidade e autorização de agentes em produção, com controles como rate limits e aprovações para mudanças, além de um “eval loop” para conectar resultados simulados ao que acontece em produção. Também há discussões sobre compressão e caching para reduzir custos de contexto de LLM, revisão de código assistida por IA em escala e como avaliar maturidade de IA além de métricas de adoção.
A OpenAI lançou o GPT-6 Sol e o GPT-6 Luna com preços de tokens reduzidos: a empresa cortou em 50% o custo de entrada em relação aos equivalentes do GPT-5.6, e a Luna teve 58% de queda nos tokens de saída. Os novos modelos também buscam ficar mais próximos do alinhamento do GPT-6 Astra, embora ainda não alcancem o modelo principal.
Além da redução de preços, a OpenAI destaca melhorias em caching e inferência para baixar ainda mais os custos no uso via API. O GPT-6 Sol e o Luna vêm com maior taxa de acerto de cache por padrão, permitem preservar contexto anterior mesmo com mudanças em esforço de raciocínio e disponibilidade de ferramentas e incluem um Prompt Caching Dashboard para monitorar e diagnosticar o desempenho do caching, com desconto de 90% para leituras de tokens de entrada em cache.
Repetir a mesma pergunta em um LLM pode gerar cobranças a cada resposta, mesmo quando nada mudou. A proposta é criar uma chave de cache por “fingerprint” dos insumos e dependências (request, contexto, configurações do modelo e dados subjacentes) e reutilizar a resposta quando ela continuar válida e segura.
O texto descreve uma estratégia em três níveis: cache exato com normalização e hash SHA-256 em um store como Redis; cache semântico com embeddings e busca por similaridade (com limiar de cosseno entre 0,90 e 0,95, ajustável); e um modelo híbrido que tenta o exato primeiro e só faz a busca semântica em caso de “miss”. Em ambos os casos, a chave precisa considerar contexto, versão de fontes e escopo de acesso para evitar reutilização incorreta entre usuários e documentos diferentes.
O Claude Code orienta como maximizar o valor de cada sessão para gastar menos tokens e evitar desperdício de contexto. A recomendação inclui limpar o histórico entre tarefas, iniciar novas sessões para reduzir contexto irrelevante e usar o prompt cache com atenção, já que ele expira após uma hora.
O texto detalha como a cobrança por token reflete o tempo de inferência e que tokens de saída custam cerca de 5x mais que tokens de entrada, além de explicar o papel do esforço (/effort) e do MAX_THINKING_TOKENS para controlar o quanto o modelo “pensa”. Também é mostrado que o prompt caching só funciona quando o início do pedido é idêntico ao que o servidor acabou de receber, evitando picos de custo ao manter a estrutura das requisições.