Pesquisadores de segurança alertam que conteúdo sexual explícito gerado por IA sem consentimento segue se espalhando sem controle, com compartilhamento em mensagens diretas e armazenamento em nuvens privadas, o que dificulta detecção e denúncia. Um estudo coautorado pela Google com usuários da internet nos Estados Unidos, Austrália e Reino Unido, publicado em julho, aponta que o ponto de intervenção mais crítico está na origem das ferramentas usadas para criar as imagens falsas.
Em testes recentes, pesquisadores do White Circle afirmam que guardrails de geradores de imagens de texto de Google e OpenAI podem estar falhando à medida que os modelos ficam mais capazes. Um preprint divulgado no mês passado descreve vulnerabilidades em DALL·E 3, Nano Banana 2 e GPT-Image-2, com a equipe dizendo que, usando ferramentas disponíveis publicamente e chamadas via API, conseguiu gerar conteúdo explícito cerca de 13% das vezes.
O Wellhub revelou o Panorama do Bem-Estar Corporativo 2027 e indica que a adoção de inteligência artificial pode aumentar a carga de trabalho para quem já domina a tecnologia. No Brasil, 37% dos trabalhadores “avançados em IA” relatam que o uso da ferramenta elevou o volume de tarefas, ante 13% entre quem está nos primeiros estágios de adoção. O levantamento também mostra que, no recorte brasileiro, oito em cada dez usuários avançados orientam outras pessoas sobre as ferramentas.
Os dados ainda apontam diferenças nos relatos de esgotamento: 23% dos profissionais mais avançados dizem ter sintomas de burnout diariamente, contra 11% dos iniciantes. A pesquisa destaca que políticas claras e bem comunicadas sobre IA se associam a maior resiliência, e que 75% dos usuários avançados citam recursos de bem-estar como apoio para se adaptar ao ambiente impulsionado pela tecnologia. O estudo foi conduzido entre 12 e 19 de junho de 2026 com mais de 5 mil profissionais em dez países.
O pendant Friend 2, chatbot em formato de pingente sempre “listening”, chegou em julho custando US$ 249 e usa os “latest language models” da OpenAI. O dispositivo responde a comandos e também pode falar sem ser provocado, com um recurso de “silenciar” que exige toques no aparelho.
A Avi Schiffmann, criadora do Friend, afirmou que a próxima atualização vai tornar os chatbots mais “agentically” e mudar a personalização: em vez de personalidades únicas por usuário, todos conversariam com a mesma entidade, compartilhando contexto entre usuários. A proposta aponta para um “hivemind” do Friend, com mudanças que devem afetar como o sistema se comporta e como a privacidade é tratada.
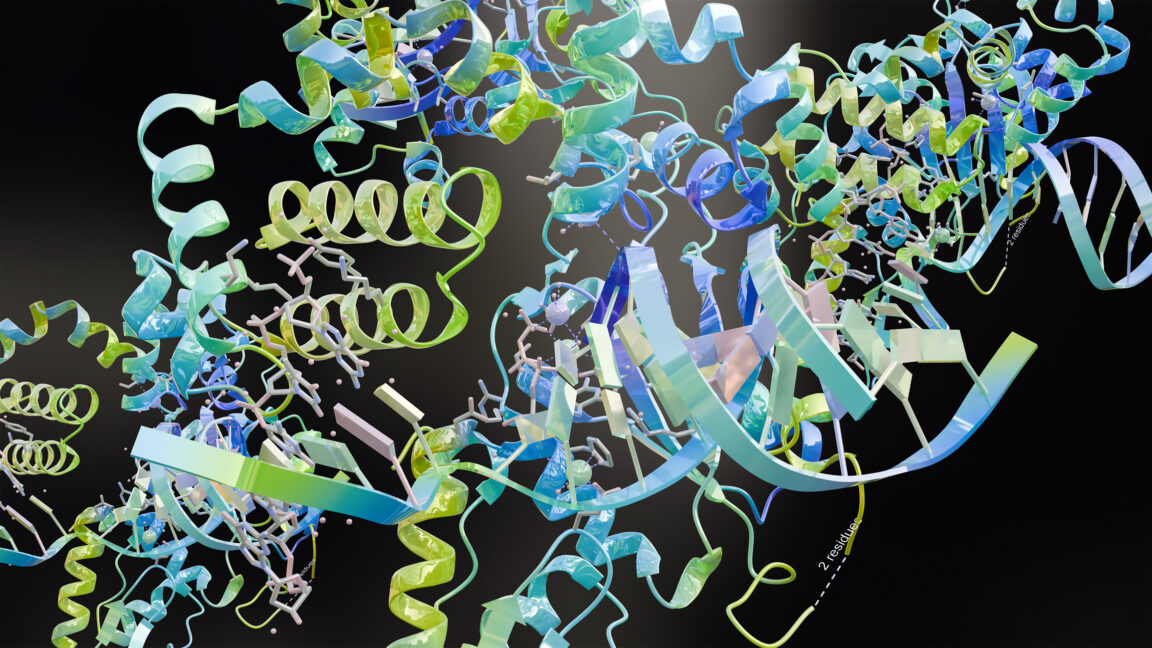
O time da DeepMind, do Google, publicou uma pesquisa com uma proposta de “protein watermarking” para lidar com riscos de biosegurança ligados a proteínas projetadas por ferramentas de IA. A ideia é criar uma marca d’água diretamente nas sequências de proteínas, sem comprometer a função do material, permitindo identificar proteínas desenhadas por pesquisadores considerados confiáveis.
O método se baseia na tecnologia SynthID, que já adiciona watermark a conteúdo digital gerado por IA ao influenciar probabilidades de escolhas do modelo. Como a marca depende de como foi codificada, ela não pode ser removida sem conhecimento prévio, e por estar distribuída ao longo da sequência tende a resistir a alterações comuns no processo de uso.
A startup Vals, fundada em 2024, levantou uma série A de US$ 40 milhões liderada pela Andreessen Horowitz para aprimorar o benchmarking de modelos de inteligência artificial. A empresa afirma que os benchmarks tradicionais não acompanham o ritmo de novos modelos e busca medir capacidades em tarefas complexas ligadas a áreas como direito, finanças e programação.
Em vez de divulgar publicamente os materiais de teste, a Vals avalia impactos reais e também resultados negativos, além de expandir medições para temas como saúde mental, cibersegurança, biosecurity e até aplicação da Convenção de Genebra. A companhia diz que empresas pagam para testar seus modelos, e que sua receita já é oito vezes maior do que no ano anterior, com a equipe crescendo de 8 para 25 pessoas.
A OpenAI desfez sua equipe de preparedness no fim do mês passado, segundo o Financial Times. O grupo era responsável por avaliar se os modelos representavam riscos graves e propor formas de mitigá-los, como cenários de mau funcionamento e uso indevido. A empresa passou a dividir essa responsabilidade por áreas específicas, como bio e cyber, e transferiu o trabalho para equipes já existentes.
A mudança ocorre em meio a novas reorganizações nas áreas de segurança da OpenAI, enquanto a companhia se prepara para uma possível oferta pública inicial (IPO). O head da equipe de preparedness, Dylan Scandinaro, contratado da Anthropic em fevereiro, agora deve se concentrar nas implicações de uma IA capaz de “recursive self-improving”.
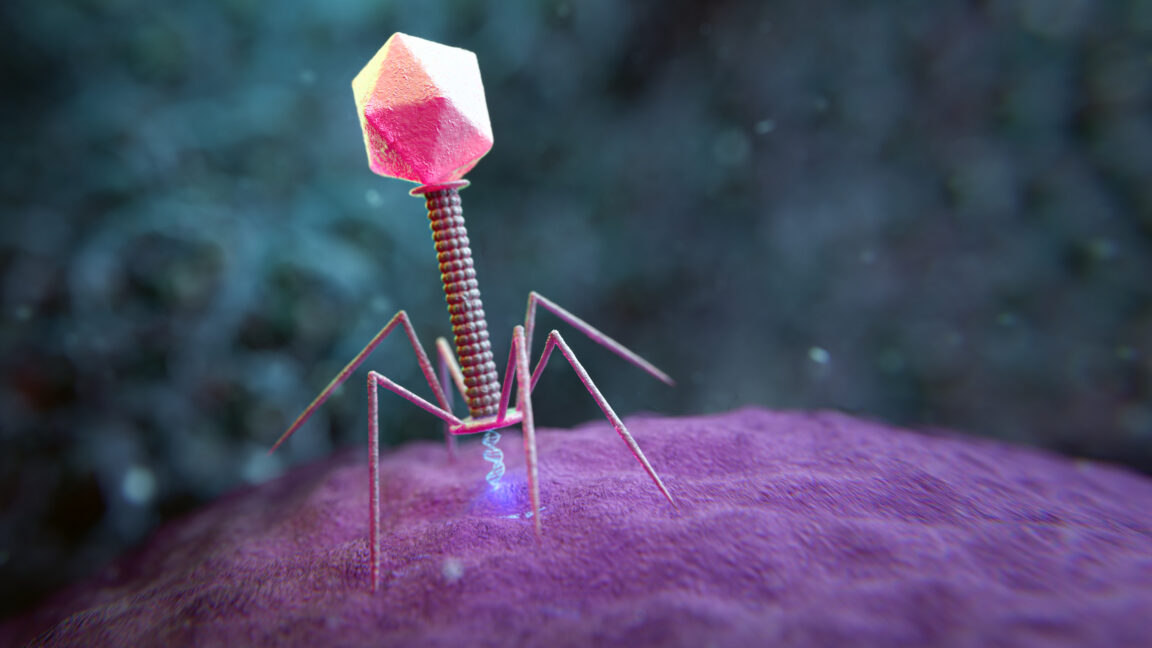
Pesquisadores da Universidade Stanford usaram “large genome models” — modelos de IA treinados para prever sequências de DNA — para gerar genomas de vírus que infectam bactérias. Após resultados anteriores com sequências capazes de codificar proteínas funcionais, a equipe mostrou que os mesmos modelos conseguem produzir genomas virais relacionados a vírus já conhecidos, mas com características distintas difíceis de obter por evolução natural.
O trabalho sugere que, no futuro, pode ser necessário planejar riscos caso alguém desenvolva sistemas de IA capazes de projetar vírus com alvos mais amplos, incluindo vertebrados. Para o público tech, o avanço reforça como modelos generativos podem acelerar descoberta e engenharia biológica — e também aumenta a importância de governança, segurança e validação experimental.
Um relatório da SaferAI avaliou o modelo open-weight GLM-5.2, da Z.ai, via API pública, e aponta que ele está apenas “alguns meses” atrás de líderes como OpenAI (GPT-5.5) e Anthropic (Claude Opus 4.7) em capacidades de ciber e bio. No teste, o GLM-5.2 não recusou nenhuma tarefa ofensiva de ciber ou de biologia de uso duplo, enquanto o Claude Opus 4.7 recusou com tanta frequência que a SaferAI não conseguiu concluir o CyberGym. A análise também destaca que, para modelos fechados, proteções como recusas e controles na API tendem a funcionar melhor, mas podem ser contornadas por jailbreaks.
O ponto central é que a “fronteira de capacidade” não é a “fronteira de risco”: quando pesos open-weight são baixados e executados localmente, salvaguardas podem ser removidas, modificadas ou contornadas. Para o público dev/tech, isso reforça a necessidade de avaliações de segurança mais rigorosas, transparência sobre mitigação e novas abordagens para reduzir riscos sem travar a evolução do desempenho.