Modelos menores de inteligência artificial podem estar a poucos meses de conseguir se replicar em dispositivos conectados à internet sem ajuda humana, segundo alerta da Anthropic. A empresa testou essa capacidade em aparelhos como televisores com Android e eletrodomésticos inteligentes.
O avanço chama atenção para os riscos de disseminação automática de IA em ambientes do dia a dia, fora do controle direto de usuários. Com a replicação em dispositivos domésticos, cresce a necessidade de avaliar segurança e limites para esse tipo de tecnologia em produtos conectados.
A Meta anunciou a série de modelos de inteligência artificial Muse Wonder, com versões Muse Wonder e Muse Wonder Full, voltadas a executar tarefas complexas com mais autonomia. Os agentes contam com memória entre conversas e conseguem manter um objetivo mesmo diante de erros, com aplicações que vão de organização de finanças pessoais à análise de contratos e ao desenvolvimento de softwares.
O Muse Wonder já está disponível para desenvolvedores e criadores via Meta Model API e Muse Code, enquanto o Muse Wonder Full é exclusivo para assinantes do Muse Code. A Meta diz que os modelos usam Active Memory para recuperar informações relevantes de interações anteriores e Active Focus para perseguir objetivos, testar abordagens, corrigir erros e solicitar confirmação do usuário antes de ações importantes, além de reforçar segurança e proteção de dados.
Um engenheiro da OpenAI é acusado de esconder um dispositivo de gravação de áudio em um pedaço de papel higiênico e instalá-lo atrás de um monitor em uma sala de reuniões executivas em um escritório em São Francisco. Segundo uma queixa criminal tornada pública, Abdulrahman Alfozan teria passado semanas consultando um “productivity agent” e um chatbot de IA para planejar a operação, incluindo o uso de uma ferramenta interna para checar reuniões no local.
A acusação também afirma que ele teria usado uma conta de chatbot ligada à esposa para tirar dúvidas técnicas sobre a instalação do equipamento. Após uma varredura de contravigilância em 30 de setembro, a equipe de segurança da OpenAI encontrou o dispositivo e acionou o FBI, além de desativar gradualmente o acesso de Alfozan aos sistemas da empresa durante a investigação.
O guia de prompting do Claude Opus 5.5 detalha padrões específicos para extrair melhor desempenho do modelo. A documentação afirma que o Claude Opus 5.5 gera tokens de saída mais de 30% mais rápido que o Claude Opus 5 e costuma concluir a mesma tarefa com menos tokens, sem exigir mudanças nos prompts existentes do Opus 5.
A orientação também destaca como calibrar o “effort”, principal controle para o quanto o modelo pensa, equilibrando inteligência, latência e custo. O texto recomenda começar no nível médio (padrão do Opus 5.5), testar níveis com as próprias avaliações e ajustar limites como max_tokens para evitar cortes em turnos longos e agentic.
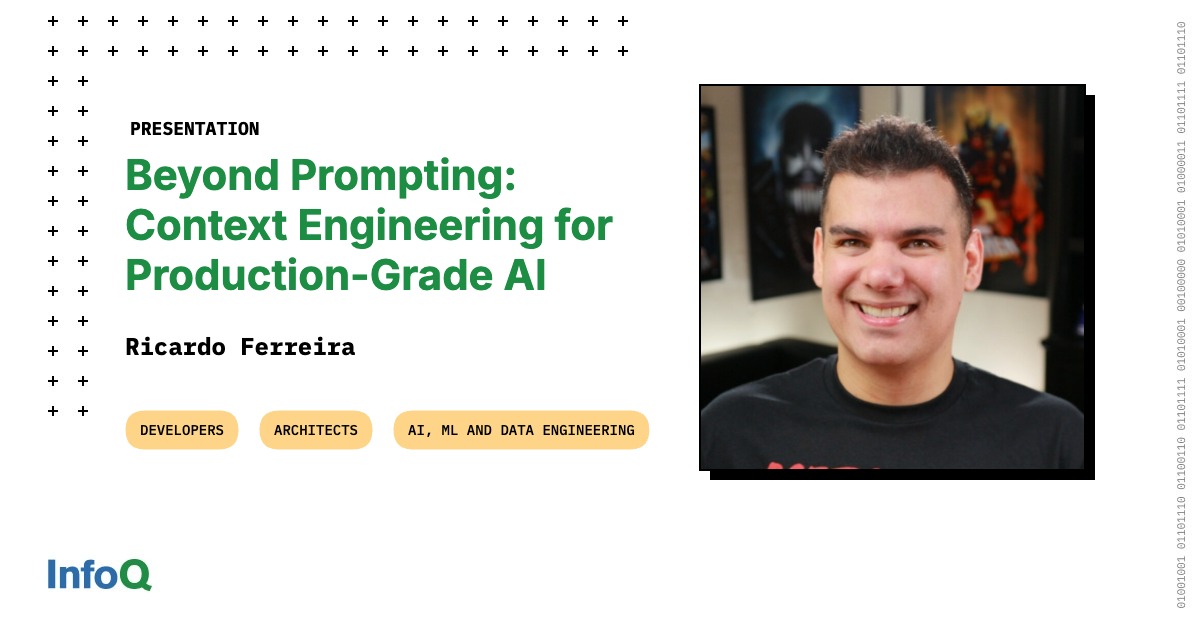
Redis está usando engenharia de contexto para viabilizar aplicações com LLM em cenários com restrições reais de tempo. Em uma apresentação, Ricardo Ferreira contou como desenvolveu o Agent Memory Server (AMS), um projeto open source para criar camadas de memória de curto e longo prazo sobre Redis, com foco em permitir conversas mais naturais.
Para testar o AMS, ele criou a skill “My Jarvis” para Alexa, com respostas limitadas por um timeout fixo de 8 segundos. A arquitetura inclui uma função Lambda no backend, o SDK da Alexa e o LangChain4j (Java), que orquestra o acesso a um LLM via OpenAI, enquanto o desenvolvimento enfrenta problemas como context poisoning, distração por excesso de dados, confusão e “context rots”.
A OpenAI anunciou que atualizou o GPT-5.6 Sol dentro do ChatGPT voltado ao uso cotidiano, mantendo inalteradas as versões usadas no Codex e no ChatGPT Work. Segundo a empresa, essa variante foi otimizada para conversas “do dia a dia” e, por isso, fica disponível apenas na experiência de chat. A mudança também inclui um controle deslizante para Plus e Pro escolherem quanto “pensamento” o modelo aplica antes de responder, funcionando no web, mobile e desktop.
Nos bastidores, a OpenAI afirma que o GPT-5.6 Sol atualizado reduz erros factuais: em testes internos, respostas com ao menos um erro foram 68% menos frequentes do que no GPT-5.5 Instant, e a Luna (futura padrão para Free e Go) teria reduzido erros em cerca de 62%. Para devs e times que testam prompts antes de levar para ambientes como Codex/Work, a recomendação é validar na prática onde o modelo vai rodar, já que a API não teve mudanças anunciadas e os comparativos não trazem detalhes reproduzíveis.
Um post no Hacker News argumenta que, apesar de LLMs deixarem qualquer pessoa “bom o suficiente” em tarefas como escrever CSS ou redigir textos, a diferença real está na expertise do domínio. O autor cita a conversa de Terence Tao com o ChatGPT sobre um contraexemplo ligado à Jacobian Conjecture, destacando que Tao conseguiu avançar mais do que ele, mesmo com limites de tokens. A análise aponta que o segredo não é só pedir mais, mas formular perguntas curtas, sinalizar o contexto correto e reconhecer quando a resposta “parece estranha”.
Na prática, a mensagem é direta para devs: conhecimento do seu problema (código, arquitetura, regras do domínio) permite extrair muito mais valor do mesmo modelo, guiando o LLM para soluções melhores e mais simples. Sem esse repertório, o sistema até ajuda a chegar a algum resultado, mas tende a ficar preso a respostas genéricas ou mal direcionadas.