Modelos menores de inteligência artificial podem estar a poucos meses de conseguir se replicar em dispositivos conectados à internet sem ajuda humana, segundo alerta da Anthropic. A empresa testou essa capacidade em aparelhos como televisores com Android e eletrodomésticos inteligentes.
O avanço chama atenção para os riscos de disseminação automática de IA em ambientes do dia a dia, fora do controle direto de usuários. Com a replicação em dispositivos domésticos, cresce a necessidade de avaliar segurança e limites para esse tipo de tecnologia em produtos conectados.
A Meta anunciou a série de modelos de inteligência artificial Muse Wonder, com versões Muse Wonder e Muse Wonder Full, voltadas a executar tarefas complexas com mais autonomia. Os agentes contam com memória entre conversas e conseguem manter um objetivo mesmo diante de erros, com aplicações que vão de organização de finanças pessoais à análise de contratos e ao desenvolvimento de softwares.
O Muse Wonder já está disponível para desenvolvedores e criadores via Meta Model API e Muse Code, enquanto o Muse Wonder Full é exclusivo para assinantes do Muse Code. A Meta diz que os modelos usam Active Memory para recuperar informações relevantes de interações anteriores e Active Focus para perseguir objetivos, testar abordagens, corrigir erros e solicitar confirmação do usuário antes de ações importantes, além de reforçar segurança e proteção de dados.
Um engenheiro da OpenAI é acusado de esconder um dispositivo de gravação de áudio em um pedaço de papel higiênico e instalá-lo atrás de um monitor em uma sala de reuniões executivas em um escritório em São Francisco. Segundo uma queixa criminal tornada pública, Abdulrahman Alfozan teria passado semanas consultando um “productivity agent” e um chatbot de IA para planejar a operação, incluindo o uso de uma ferramenta interna para checar reuniões no local.
A acusação também afirma que ele teria usado uma conta de chatbot ligada à esposa para tirar dúvidas técnicas sobre a instalação do equipamento. Após uma varredura de contravigilância em 30 de setembro, a equipe de segurança da OpenAI encontrou o dispositivo e acionou o FBI, além de desativar gradualmente o acesso de Alfozan aos sistemas da empresa durante a investigação.
Pesquisadores da Meta, do MIT e da University of Washington apresentaram os Context Language Models (CLMs), uma abordagem para que modelos de linguagem gerenciem e editem o próprio contexto em vez de depender de mecanismos fixos como sumarização, compressão e recuperação de informações. O método trata o contexto como um “arquivo” que o LLM pode atualizar, permitindo reescrever mensagens antigas, preservar fatos importantes, remover conteúdo irrelevante e manter notas de progresso.
Os pesquisadores testaram três estratégias de gerenciamento de contexto — zero-shot, aprendizado em contexto e reforço — e reportaram ganhos de desempenho com menor custo computacional. Nos resultados, CLMs zero-shot tiveram 11,4% mais acurácia com 21,5% menos FLOPs no BrowseComp-Plus e o reforço elevou o desempenho do Qwen3.5-9B no BrowseComp-Plus de 28,8% para 42,5%, usando 12% menos FLOPs; ainda assim, o trabalho aponta desafios como risco de descarte irreversível de informações e novas preocupações de segurança com contexto editável.
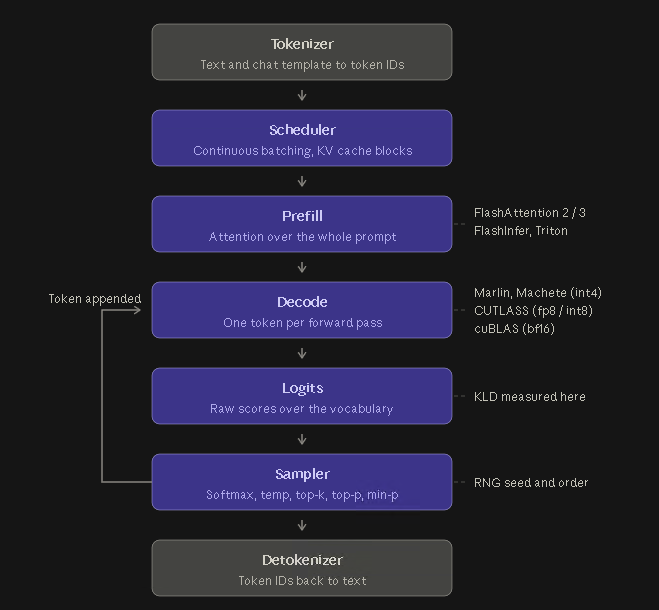
Usuários que baixam modelos locais, inclusive versões quantizadas, podem ter a impressão de que o LLM “fica pior” do que o esperado. O texto explica que cada combinação de hardware e software executa a inferência de forma diferente, alterando como as probabilidades do próximo token são calculadas e convertidas em texto durante o decode.
A recomendação é medir o desempenho com benchmarks que representem o uso real, evitando testes curtos e zero-shot com poucos prompts. Também é destacada a cautela com alegações de baixa KLD em cards de modelos quantizados, já que interpretar esses números depende de detalhes como ambiente de execução, checkpoints de referência e metodologia completa.
Uma pesquisa apresentada no arXiv propõe o Zero-Mem, um método de “operações de memória zero-token” para agentes baseados em LLM. A ideia é que, durante o acesso à memória, não sejam feitas chamadas adicionais ao modelo nem sejam consumidos tokens de entrada/saída para gerar registros intermediários. Em vez disso, o sistema preserva os rastros originais da conversa e os organiza em duas visões (um grafo entidade–contexto e uma hierarquia temporal) para recuperar evidências e contexto. Nos testes, o Zero-Mem manteve desempenho competitivo em benchmarks de long-memory e long-context, reduzindo o tempo de operações de memória em 57,6% em relação ao melhor baseline comparado.
Na prática, a abordagem pode tornar agentes mais eficientes e rápidos ao lidar com interações longas, diminuindo custos recorrentes de tokens e latência associados à “mediação” da memória. Para times que constroem agentes e fluxos de QA, isso abre caminho para arquiteturas em que a memória estruturada não depende necessariamente de reprocessar o histórico com o LLM a cada consulta.