Pesquisadores de segurança alertam que conteúdo sexual explícito gerado por IA sem consentimento segue se espalhando sem controle, com compartilhamento em mensagens diretas e armazenamento em nuvens privadas, o que dificulta detecção e denúncia. Um estudo coautorado pela Google com usuários da internet nos Estados Unidos, Austrália e Reino Unido, publicado em julho, aponta que o ponto de intervenção mais crítico está na origem das ferramentas usadas para criar as imagens falsas.
Em testes recentes, pesquisadores do White Circle afirmam que guardrails de geradores de imagens de texto de Google e OpenAI podem estar falhando à medida que os modelos ficam mais capazes. Um preprint divulgado no mês passado descreve vulnerabilidades em DALL·E 3, Nano Banana 2 e GPT-Image-2, com a equipe dizendo que, usando ferramentas disponíveis publicamente e chamadas via API, conseguiu gerar conteúdo explícito cerca de 13% das vezes.
O Wellhub revelou o Panorama do Bem-Estar Corporativo 2027 e indica que a adoção de inteligência artificial pode aumentar a carga de trabalho para quem já domina a tecnologia. No Brasil, 37% dos trabalhadores “avançados em IA” relatam que o uso da ferramenta elevou o volume de tarefas, ante 13% entre quem está nos primeiros estágios de adoção. O levantamento também mostra que, no recorte brasileiro, oito em cada dez usuários avançados orientam outras pessoas sobre as ferramentas.
Os dados ainda apontam diferenças nos relatos de esgotamento: 23% dos profissionais mais avançados dizem ter sintomas de burnout diariamente, contra 11% dos iniciantes. A pesquisa destaca que políticas claras e bem comunicadas sobre IA se associam a maior resiliência, e que 75% dos usuários avançados citam recursos de bem-estar como apoio para se adaptar ao ambiente impulsionado pela tecnologia. O estudo foi conduzido entre 12 e 19 de junho de 2026 com mais de 5 mil profissionais em dez países.
O pendant Friend 2, chatbot em formato de pingente sempre “listening”, chegou em julho custando US$ 249 e usa os “latest language models” da OpenAI. O dispositivo responde a comandos e também pode falar sem ser provocado, com um recurso de “silenciar” que exige toques no aparelho.
A Avi Schiffmann, criadora do Friend, afirmou que a próxima atualização vai tornar os chatbots mais “agentically” e mudar a personalização: em vez de personalidades únicas por usuário, todos conversariam com a mesma entidade, compartilhando contexto entre usuários. A proposta aponta para um “hivemind” do Friend, com mudanças que devem afetar como o sistema se comporta e como a privacidade é tratada.
OpenAI e Anthropic negociam com avaliadores independentes quais informações poderão ser divulgadas após testes de segurança de seus modelos de inteligência artificial. O impasse envolve a proteção de segredos comerciais e a transparência sobre possíveis riscos, com dúvidas sobre a independência dos especialistas.
Os testes incluem equipes externas dentro dos laboratórios, o que facilita a análise, mas pode gerar conflitos quando informações confidenciais são necessárias para identificar falhas. Um exemplo citado é a investigação sobre um incidente na Hugging Face, em que pesquisadores relataram dificuldades de acesso e ajustes no relatório após comentários das empresas, enquanto uma carta com mais de 200 pesquisadores defende autonomia editorial, acesso aos sistemas e proteção contra retaliações.
Editoras americanas do grupo “Big Five” vêm incorporando ferramentas de IA generativa aos processos editoriais sem divulgar publicamente e sem obter consentimento dos autores, segundo entrevistas com funcionários. HarperCollins, Simon & Schuster e Hachette usariam LLMs como Claude e ChatGPT para tarefas como e-mails para agentes literários, textos de divulgação e contracapa, criação de materiais de marketing e até design de capas.
Em HarperCollins, líderes teriam comprado licenças de Claude e criado um programa interno para identificar casos de uso, enquanto preocupações sobre impactos legais, éticos e ambientais teriam sido tratadas como “custo de fazer negócios”. O uso de IA também aparece em suspeitas entre agentes sobre cartas de rejeição escritas com sinais típicos de IA, enquanto Simon & Schuster e Hachette dizem apoiar apenas usos operacionais e com ferramentas aprovadas.
A startup britânica Books by People recebeu aprovação do UK Intellectual Property Office para começar a distribuir um selo que indica que um livro foi escrito por uma pessoa, sem uso de máquinas. O marcador, com formato de impressão digital, será exibido na capa e faz parte de um processo de verificação que inclui declaração de autoria e análise manual de rascunhos e materiais de pesquisa.
A iniciativa surge após uma série de controvérsias na indústria editorial envolvendo suspeitas de uso de IA por autores. A Books by People afirma que usa software proprietário e busca “indicadores de humanidade” durante a avaliação, cobrando uma taxa de adesão dos publishers e um valor adicional por obra certificada, com a expectativa de lançar o selo no primeiro livro ainda este ano.
David Robinson, ex-funcionário de segurança da OpenAI que escrevia relatórios de segurança para lançamentos de modelos, pediu demissão e passou a alertar em editorial no The Atlantic. Ele afirma que a cultura da empresa está “broken” e que o problema é mais profundo do que apenas criar novas regras para o treinamento de modelos.
Robinson diz que a indústria opera com “extreme confidence” e “perpetual sprints”, acelerando o desenvolvimento de modelos com “unimpeded optimism” e subestimando riscos. Ele defende que laboratórios de IA adotem salvaguardas “nível nuclear”, com redundância e planejamento cuidadoso, e aponta que outros profissionais de segurança também deixaram empresas como Anthropic e Google DeepMind.
Dario Amodei, CEO da Anthropic, propôs que avaliadores independentes sejam incorporados a todas as “frontier AI companies”, com poder para reportar incidentes de segurança, avaliar se os modelos estão realmente alinhados e divulgar os achados sem “controle editorial”. Amodei disse que a Anthropic daria acesso sem precedentes a avaliadores como METR e Redwood Research, e Sam Altman indicou que a OpenAI também seguiria a prática.
A proposta é vista com bons olhos por avaliadores ouvidos pelo TechCrunch, mas eles pedem detalhes para garantir independência real, incluindo acesso a versões intermediárias (“checkpoints”) e verificação de logs e transcrições de avaliação. O debate também envolve limites de tempo e acesso: casos anteriores com METR e Redwood e testes citados para GPT-6 Astra apontam janelas curtas que dificultaram conclusões confiáveis, levantando a pergunta sobre o que mudará na prática.
A startup Pangram, com 24 funcionários e sede em Brooklyn, promete estimar o quanto um texto foi gerado com participação de IA, fornecendo um percentual de “AI involvement”. A empresa ganhou destaque após acusações públicas envolvendo livros e colunas: a estimativa atribuída à Pangram chegou a 78% no caso de “Shy Girl”, e a Hachette cancelou a publicação; depois, a ferramenta também foi citada em episódios como a Modern Love do The New York Times, com pontuação de 100%, e em obras como “Daggermouth” (60%) e “Call Me, I’ll Hide the Body” (97%).
Em julho, a Substack anunciou a integração da Pangram à plataforma para que leitores possam verificar rapidamente possíveis usos de IA. A demanda cresce com a popularização de LLMs e a necessidade de diferenciar escrita humana de “churn” gerado por modelos, mas o tema também enfrenta resistência de autores e especialistas do setor editorial, que criticam a detecção por software e questionam a confiança na ferramenta.
A União Europeia começou a aplicar novas regras de transparência para conteúdos criados ou modificados por inteligência artificial. O Artigo 50 do AI Act, em vigor desde 2 de agosto, determina que empresas identifiquem imagens, vídeos e áudios gerados por IA quando eles puderem ser confundidos com conteúdo real.
A regra também vale para certos textos produzidos ou manipulados por IA sobre temas de interesse público, quando não houver revisão humana ou controle editorial. O descumprimento pode levar a multas de até 15 milhões de euros ou 3% do faturamento anual mundial, e a UE permite diferentes abordagens, como marcas d’água invisíveis e metadados, além de rótulos visuais para o usuário.
A Anthropic passou a inserir watermarks invisíveis nas respostas do Claude, adicionando um código no texto editorial do chatbot para marcar o conteúdo como gerado por IA. A mudança foi implementada para atender ao EU AI Act e ao Transparency Code, que exige rotulagem de conteúdos gerados ou editados de forma identificável por sistemas computacionais.
Enquanto reguladores europeus podem ver a medida como necessária, usuários do Claude no Reddit reagiram com críticas e descontentamento. Parte dos participantes argumentou que a marcação poderia “pegar” estudantes e profissionais que usam o chatbot para tarefas como reorganizar parágrafos e resumir transcrições, enquanto outros defenderam a política como um meio de detectar saídas de IA e reduzir riscos.
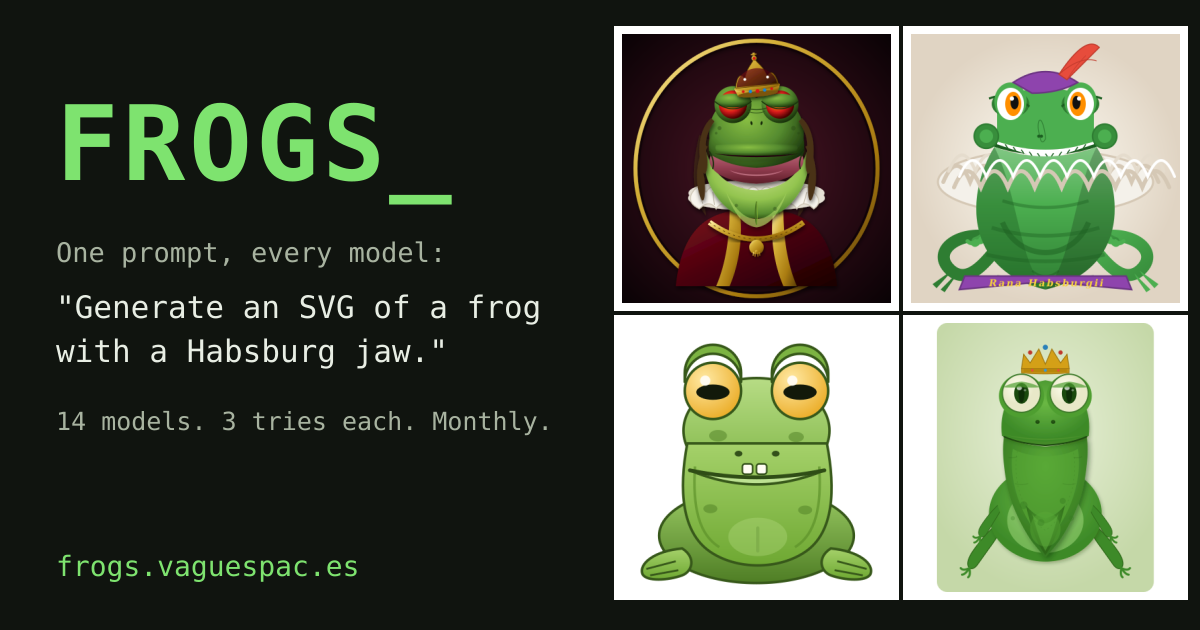
Um usuário compartilhou um “benchmark” pessoal usando o Claude Opus (da Anthropic) para gerar SVGs a partir de prompts. No exemplo citado, o modelo produziu um desenho de um sapo com anotações estruturais e descrições editoriais exagerando a anatomia, incluindo a “mandíbula Habsburgo” e dentes inferiores projetando sobre o lábio superior.
O que chama atenção é como o modelo consegue interpretar instruções e ainda adicionar interpretações “criativas” ao detalhar partes do desenho. Para devs e makers, isso reforça a utilidade de LLMs para gerar assets (como SVG) e também a necessidade de revisar/ajustar prompts quando o objetivo é precisão visual ou consistência anatômica.