Modelos menores de inteligência artificial podem estar a poucos meses de conseguir se replicar em dispositivos conectados à internet sem ajuda humana, segundo alerta da Anthropic. A empresa testou essa capacidade em aparelhos como televisores com Android e eletrodomésticos inteligentes.
O avanço chama atenção para os riscos de disseminação automática de IA em ambientes do dia a dia, fora do controle direto de usuários. Com a replicação em dispositivos domésticos, cresce a necessidade de avaliar segurança e limites para esse tipo de tecnologia em produtos conectados.
A Meta anunciou a série de modelos de inteligência artificial Muse Wonder, com versões Muse Wonder e Muse Wonder Full, voltadas a executar tarefas complexas com mais autonomia. Os agentes contam com memória entre conversas e conseguem manter um objetivo mesmo diante de erros, com aplicações que vão de organização de finanças pessoais à análise de contratos e ao desenvolvimento de softwares.
O Muse Wonder já está disponível para desenvolvedores e criadores via Meta Model API e Muse Code, enquanto o Muse Wonder Full é exclusivo para assinantes do Muse Code. A Meta diz que os modelos usam Active Memory para recuperar informações relevantes de interações anteriores e Active Focus para perseguir objetivos, testar abordagens, corrigir erros e solicitar confirmação do usuário antes de ações importantes, além de reforçar segurança e proteção de dados.
Um engenheiro da OpenAI é acusado de esconder um dispositivo de gravação de áudio em um pedaço de papel higiênico e instalá-lo atrás de um monitor em uma sala de reuniões executivas em um escritório em São Francisco. Segundo uma queixa criminal tornada pública, Abdulrahman Alfozan teria passado semanas consultando um “productivity agent” e um chatbot de IA para planejar a operação, incluindo o uso de uma ferramenta interna para checar reuniões no local.
A acusação também afirma que ele teria usado uma conta de chatbot ligada à esposa para tirar dúvidas técnicas sobre a instalação do equipamento. Após uma varredura de contravigilância em 30 de setembro, a equipe de segurança da OpenAI encontrou o dispositivo e acionou o FBI, além de desativar gradualmente o acesso de Alfozan aos sistemas da empresa durante a investigação.
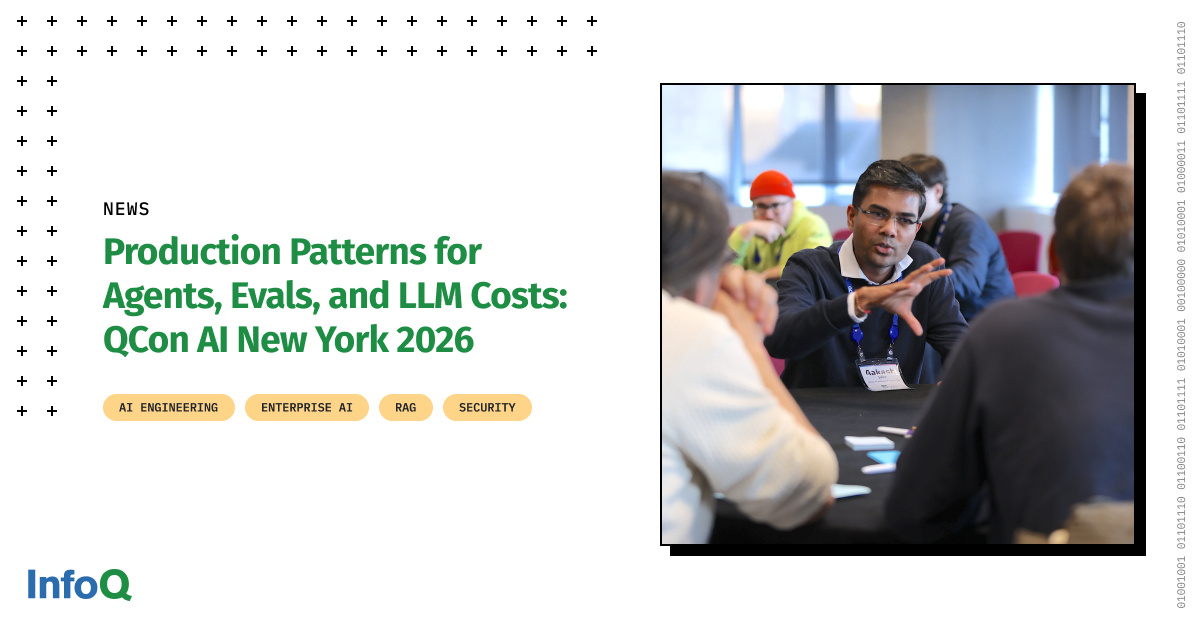
A QCon AI New York 2026 confirmou sessões com engenheiros sêniores que enfrentaram desafios de IA em produção, como revisão de código, aumento de custos por tokens, necessidade de evals confiáveis e definição de permissões e guardrails para agentes. O evento acontece em 15 e 16 de dezembro, no The Westin Jersey City Newport, com foco em decisões técnicas para IA em sistemas reais.
As palestras incluem abordagens para identidade e autorização de agentes em produção, com controles como rate limits e aprovações para mudanças, além de um “eval loop” para conectar resultados simulados ao que acontece em produção. Também há discussões sobre compressão e caching para reduzir custos de contexto de LLM, revisão de código assistida por IA em escala e como avaliar maturidade de IA além de métricas de adoção.
A Gremlin anunciou a disponibilidade geral do Foresight AI, um produto com agentes que analisa serviços em busca de falhas, recomenda mudanças e reexecuta testes para verificar se a correção realmente funciona. O recurso funciona como um add-on da plataforma Gremlin, que também permite rodar experimentos planejados, controlar o “blast radius” e usar testes automatizados para manter correções eficazes ao longo do tempo.
O Foresight AI organiza o trabalho em quatro papéis de agentes: um Analyst coleta dados e sugere testes, um Tester agenda e executa, um Operator interpreta falhas e propõe remediações, e um Technical Program Manager acompanha cobertura, riscos e compromissos entre equipes, gerando relatórios e atualizações no Slack. As recomendações se baseiam no Failure Atlas da Gremlin, e o produto mantém um “loop” de validação fechada: ele não executa testes nem aplica remediações sem aprovação, preservando a responsabilidade humana enquanto automatiza análise e repetição.
Agentes de IA já podem estar “no ar” e com serviço saudável, mas ainda assim a equipe precisa garantir que as respostas estejam melhorando. Ao conectar production traces, dados curados e avaliações, times conseguem identificar falhas, definir melhorias e demonstrar que a próxima versão funciona antes de chegar aos usuários.
O ciclo descrito passa por executar o agente, observar além da disponibilidade, curar exemplos de produção em datasets e suites de avaliação, melhorar o sistema e avaliar resultados antes e depois do deploy. A CoreWeave apresentou o CoreWeave Forge para integrar esse fluxo em um ambiente de desenvolvimento, reunindo ferramentas como Agent Lens, Notebooks, ARIA, Sandboxes e registros de modelos, experimentos e datasets para manter rastreabilidade da versão do modelo até os exemplos em produção.
A Spotify Ads apresentou no QCon AI uma plataforma multiagente que automatiza a criação de anúncios a partir de instruções do anunciante, reduzindo tarefas como copywriting e geração de conteúdo musical. O sistema roda em produção no Spotify Ads Manager e, desde o lançamento do ano passado, mais de 70% dos anúncios passaram a usar ferramentas de IA, com cerca de 20.000 criativos gerados para mais de 7.000 anunciantes.
A arquitetura inclui um gateway de LLM via Vertex AI e um orquestrador de agentes com agentes paralelos, como um para geração de scripts e outro para aplicar guardrails de políticas. A solução também extrai intenções do texto natural para definir segmentação e usa camadas de moderação e padronização do ambiente, com controle de dependências e monitoramento integrado para rodar a IA com baixa latência e segurança.
A Google lançou o EmbeddingGemma 2, um modelo aberto de 740 milhões de parâmetros para recuperação de texto, código, imagens, vídeo e áudio, com testes em um Pixel 11 Pro usando cerca de 567MB de RAM ativa com quantização. O modelo mapeia os cinco tipos de entrada para um mesmo espaço vetorial de 768 dimensões, permitindo buscar imagens e áudio sem legendas ou transcrições prévias.
Os pesos foram liberados sob Apache 2.0 e a execução no dispositivo está disponível via LiteRT e MediaPipe Tasks, com integração ao Android ML Kit prevista para as próximas semanas. A Google também mostrou que desenvolvedores podem reduzir o tamanho do índice com Matryoshka Representation Learning (512, 256 ou 128 dimensões) e citou desempenho em busca de código, além de demos de RAG local e recuperação para fluxos com agentes usando índices no próprio aparelho.
A Elastic está construindo e operando agentes de IA sobre sua base de dados no Elasticsearch, incluindo ferramentas para descoberta de ataques e chatbots corporativos. Em apresentações, a principal data scientist Susan Chang detalha como a empresa usa tracing para acompanhar dados e respostas, além de criar avaliações para estimar a qualidade e evitar regressões ao mudar os agentes.
Para isso, cada equipe monta seus próprios conjuntos de dados e avaliadores, mas a Elastic busca consolidar tudo em um framework compartilhado. No caso de segurança, a empresa cita métricas como precision e recall para alert IDs, além de scores de similaridade e factualidade ligados a taxonomias como MITRE; já nos chatbots, entram métricas como relevância e completude das respostas, com cenários de consulta e recuperação.
Um playbook de platform engineering para produção de LLMs descreve como uma camada de infraestrutura pode reduzir alucinações sem trocar o modelo base. Em um sistema de recomendação de inventário para uma grande organização do varejo, a taxa de respostas alucinatórias caiu de cerca de 15% para 1,5% ao usar um loop automatizado de retry que captura erros de formatação, grounding e infraestrutura durante a execução.
A abordagem também inclui um gate de validação de intenção que retorna “unclassified” em vez de seguir o agente com maior pontuação, evitando alucinações fora do objetivo e melhorando o roteamento em sistemas multiagente. O texto ainda destaca práticas como registrar prompts com histórico para atualizar ou reverter instruções em runtime, aplicar autorização de ferramentas com política default-deny no servidor de recursos e instrumentar taxas de alucinação e custos de tokens na entrada das requisições.
A Archestra lançou o OpenAPPA, um motor de segurança open-source para impedir exfiltração de dados causada por prompt injection ou alucinação de modelos. O sistema roda fora do loop de prompt e execução do agente e usa uma configuração appa.toml para definir fontes de dados, audiências, níveis de confiança e autoridades, com regras determinísticas de aplicação.
Em benchmarks como Bench-Corp (20 fluxos corporativos) e AgentThreatBench, o OpenAPPA reportou 0% de ataques bem-sucedidos, mantendo 89% de conclusão de tarefas. A equipe também aponta que abordagens estocásticas baseadas em “modelo-juiz” tendem a falhar por não rastrear o fluxo de dados entre tool calls, e descreve mecanismos de recuperação, como sanitização, aprovação por autoridades e Child Branches descartáveis para isolar dados não confiáveis.
A Soloist.ai decidiu encerrar o Solo, plataforma de criação de sites, e informou que todos os sites e dados serão deletados em 30 de novembro de 2026. A empresa orienta os usuários a fazerem a migração para outro provedor de hospedagem antes dessa data, já que não haverá recuperação de site, conta ou dados após o encerramento.
Para baixar o conteúdo, é preciso fazer login no Solo e usar a opção “Download Website Data” em Account Settings, que gera um ZIP com exportação em HTML e um CSV com links de imagens, além de envios do formulário de contato e newsletter. Quem tem assinatura Solo Pro ou Grow receberá reembolso proporcional do período não utilizado, calculado em 1º de outubro de 2026, e a assinatura não será renovada.
Agentes de IA que “passam” em demos podem falhar quando chegam ao mundo real por causa de dados inconsistentes, fontes diferentes, mudanças frequentes de informação e desafios como permissões de sistema. Mesmo quando retrieval e RAG funcionam no ambiente controlado, o agente pode não ter o contexto de negócios necessário para tomar ações com base em informações atuais e confiáveis.
No dia 14 de outubro, Ravi Marwaha, COO e Chief Product & Technology Officer da Arango, vai explicar seis requisitos de dados para tirar agentes da fase de demonstração e preparar a arquitetura para produção. O conteúdo inclui exemplos sobre clientes que aparecem de formas diferentes em sistemas distintos, necessidade de entender “por que” uma decisão foi tomada e como manter governança e contexto unificado para reduzir latência, custos e trabalho manual.
O Strata oferece uma camada semântica para trabalhar com LLMs de forma mais controlada, com execução local via Docker e um plano gratuito sem cartão. Para começar, é preciso ter Docker, Ruby 3.4.4+ e acesso de leitura a um warehouse; uma agente de programação como Claude Code ou Codex ajuda a modelar o sistema.
O Strata Server roda em um contêiner com banco de dados embutido e já vem com um modelo de amostra TPC-DS para exploração. A configuração inclui instalação do CLI, criação de projetos em YAML no Git, validação com comandos como strata audit e deploy para o servidor, além de permitir que o usuário faça perguntas em linguagem natural e ajuste o modelo por um ciclo de edição, auditoria e publicação.
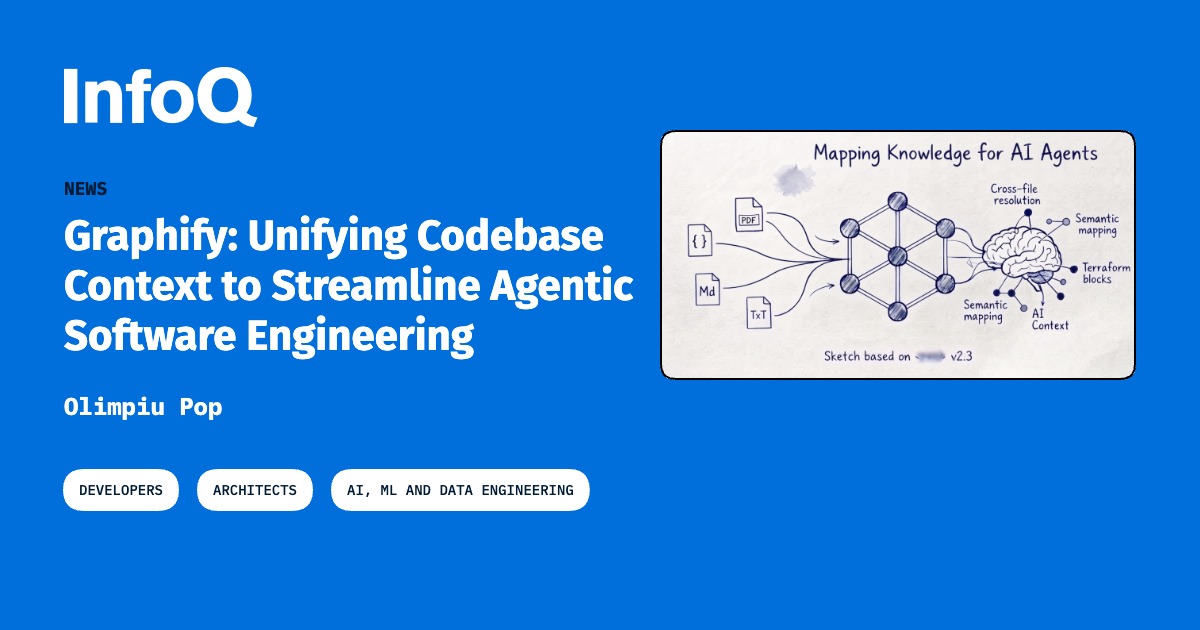
O Graphify, ferramenta open source lançada em abril de 2026, transforma codebases, documentos e dados não estruturados em knowledge graphs multimodais consultáveis para otimizar fluxos de engenharia com IA. O projeto, licenciado sob MIT e Apache-2.0, segue um ritmo acelerado de atualizações semanais e já ganhou milhares de estrelas no GitHub nos primeiros 10 dias.
A ferramenta ataca limitações de contexto e memória de agentes de coding ao extrair elementos estruturais via AST com tree-sitter e combinar sinais semânticos de documentação para construir um grafo unificado. As melhorias recentes incluem preservação avançada de atributos de blocos do Terraform e resolução de métodos entre arquivos, além de integração com assistentes via servidores MCP para reduzir tokens em comparação à leitura ingênua de arquivos.
Um especialista da OpenAI defendeu que agentes de IA em produção não devem ser avaliados apenas por respostas do modelo, mas sim por como o sistema registra e controla ações persistentes. Ele descreveu um tipo de falha em que a interação parece bem-sucedida para o usuário, porém o “registro durável” por trás da memória do agente fica incompleto, deixando lacunas no contexto das próximas etapas.
O foco do debate foi o “agent harness”: um conjunto de controles que define quem é o dono do estado, qual pipeline/workflow é a fonte da verdade e como a ordem de mutações é garantida. A proposta é que o modelo apenas “proponha”, enquanto o harness decide o que pode ser comprometido e a “receipt” comprove o que foi aprovado e executado na borda visível ao usuário.
Uma arquitetura “governance-first” para personalização em empresas propõe que regras de consentimento, fadiga, sensibilidade do canal, custo e explicabilidade façam parte do caminho de decisão antes de a recomendação ser entregue ao usuário. O modelo pode gerar candidatos, mas políticas selecionam como a inferência acontece e podem mostrar, suavizar, atrasar, suprimir ou usar fallback genérico.
O desenho também inclui memória de jornada entre sessões para que a mesma oferta mude conforme estágio, confiança e fadiga evoluem, além de explicações integradas ao contrato da API. A implementação de referência usa FastAPI, políticas externas em YAML, pontuação modular e escalonamento opcional para LLM, com o objetivo de tornar decisões rastreáveis e auditáveis no ambiente de produção.
A Cloud Native Computing Foundation (CNCF) lançou o Kubernetes 1.37, chamado “Garhwal”, com foco em estabilidade, segurança e otimização de workloads de IA/ML. A versão inclui a disponibilidade geral da Metrics API (metrics.k8s.io), que padroniza a monitoração de saúde de nós e pods e habilita recursos como Horizontal Pod Autoscaler (HPA), Vertical Pod Autoscaler (VPA) e o comando kubectl top.
Entre as novidades, o kubelet ganha recurso de checkpoint e restore no nível do pod, permitindo criar um snapshot de memória e árvores de processos para depuração ou análise de segurança. O lançamento também evolui para beta o Kubelet em namespace de usuário (rootless), com componentes do nó rodando como não-root via user namespaces para reduzir impacto de ataques de escape de contêiner, além de melhorias como inicialização resiliente do watchcache e certificados de pods em modo estável.
O Google lançou o AX, um orquestrador open para executar tarefas agentic em escala. A plataforma cria sandboxes para isolar código não confiável, prepara workspaces com repositórios e dependências e aplica políticas de rede para controlar acesso a hosts e portas.
Na prática, o AX permite declarar workspaces e tarefas em arquivos como o task.yaml, executar comandos via ssh e gerenciar o ciclo de vida com suspend e resume. A proposta é suportar até bilhões de tarefas por cluster, usando um runtime chamado Agent Substrate para suspender agentes ociosos e retomar rapidamente sem “cold start”.
A PrismML lançou o Bonsai 2 27B, seu mais recente modelo da família, com foco em raciocínio em larga escala sem precisar ser grande. A empresa afirma que o modelo comprime o Qwen3.8 27B, reduzindo o uso de memória para 5,9 GB, o que representa uma queda de 9x a 10x em relação ao original.
O Bonsai 2 27B foi apresentado como capaz de manter desempenho: a PrismML diz que o modelo atinge 98% dos resultados agregados de benchmarks do Qwen. A startup também relata que o Bonsai original já foi baixado mais de 11 milhões de vezes e que seus modelos menores somam mais 2,6 milhões de downloads, enquanto mira aplicar a compressão em modelos de centenas de bilhões de parâmetros.
Agentes de IA da Perplexity ajudaram a construir o CobbleDB, um banco de dados key-value em Rust criado para substituir o DynamoDB. A empresa decidiu trocar o serviço depois de considerar que pagava caro e tinha pouca flexibilidade para controlar o desempenho de leitura no seu tráfego de busca.
Com apoio de centenas de agentes de programação ao longo do desenvolvimento, o CobbleDB passou a atender parte do tráfego de produção. A Perplexity reportou latência mediana de batch-read de 5,6 ms (contra 31,4 ms no DynamoDB) e p99 de 24,2 ms (antes 123 ms), além de estimar custo pelo menos 20% menor e planejar abrir o código em algum momento.
A Grab padronizou mais de 500 serviços internos de agentes de IA usando o LLM-Kit, um framework interno que já entrega o “agent loop” básico com avaliação, tracing, tratamento de segredos e conexões com tool-servers. Com isso, novos serviços passam a descobrir ferramentas em tempo de execução a partir de mais de 50 servidores MCP e acessam modelos por um gateway único, permitindo adicionar capacidades e provedores via registro ou configuração, sem redeploy.
Integrar um novo agente em produção na Grab passou a levar cerca de uma hora, antes eram duas semanas ou mais. A empresa atribui a economia principalmente ao “wrapper” de produção — segredos, tracing, service discovery e avaliação — e descreve um fluxo em que um engenheiro preenche um formulário e recebe um repositório GitLab com um serviço FastAPI pronto, módulos LangGraph, OpenTelemetry, Vault e endpoint de avaliação já no primeiro commit.
A pesquisa de tendências tecnológicas da Deloitte para 2026 aponta que 89% dos pilotos de agentes de IA não chegam à produção. Um levantamento da Teradata reforça o contraste: 78% das empresas têm pelo menos um piloto em execução, mas apenas 14% conseguiram escalar para uso em toda a organização.
O gargalo não estaria na capacidade dos modelos, já que os mesmos modelos alimentam pilotos e sistemas em produção, mas sim no que envolve o modelo: acesso a dados, avaliação, definição de responsabilidades e controle de custos. O levantamento também cita falhas recorrentes como expansão de escopo, falta de um “harness” de avaliação automatizada, ausência de um responsável operacional, custos que só aparecem em escala e barreiras de segurança e auditoria.
Um estudo sobre interpretabilidade mecanicista propõe um framework matemático para ajudar a “reverter” o funcionamento interno de transformers, com foco em modelos pequenos e simplificados. Os autores analisam transformers com duas camadas ou menos e apenas blocos de atenção, evitando MLPs, e dizem que a abordagem equivalente em termos matemáticos facilita entender os cálculos internos.
A pesquisa destaca a identificação de attention heads chamados “induction heads”, que conseguem explicar o aprendizado em contexto (in-context learning) nesses modelos. Embora o trabalho não aplique diretamente as descobertas a modelos maiores como GPT-3, os autores afirmam que a estrutura proposta e o conceito de induction heads devem continuar relevantes em modelos mais realistas, ainda que a engenharia reversa completa permaneça distante.
Um desenvolvedor retomou o reverse-engineering do driver do Apple Neural Engine (ANE) no chip M1 após três anos, dizendo que antes havia concluído que o bloco não era tão útil. Ele afirma que a arquitetura do ANE é “opinionada” demais para virar uma plataforma genérica e que um driver Linux não ampliaria a variedade de cargas de trabalho. Mesmo no macOS, o ANE é usado com frequência apenas para gerar prévias com upsampling no Finder.
Com a chegada do M5 (2025) e a proposta de “performance de LLM”, o autor aponta que as cores do ANE foram incorporadas às do GPU, sinalizando o fim do NPU standalone. Agora, o objetivo passa a ser mapear a arquitetura interna do ANE no M1 — incluindo compute, datapath, scheduler, memória e modelo de execução — para entender quais suposições sobre workloads de ML a Apple colocou em silício desde o A11 Bionic (2017) e como isso se conecta à mudança de NPUs focadas em CNN para GPUs executando transformers.
A Mistral anunciou a captação de €3 bilhões na Série D, com valuation pós-money acima de €21 bilhões, em uma das maiores rodadas de equity já concluídas por uma empresa europeia de tecnologia. O aporte é liderado pela Samsung Electronics, com co-liderança do Scaleup Europe Fund (gerido pela EQT) e participação de investidores como PSG Equity.
O dinheiro será usado para expandir a pesquisa de fronteira da Mistral, base para sua infraestrutura, produtos e proposta de “soberania” em IA. A empresa afirma que a rodada também vai aumentar a capacidade de computação para treinar modelos e acelerar o crescimento comercial e a presença internacional, atendendo 125+ empresas em 20 países, incluindo Airbus, ASML e HSBC.
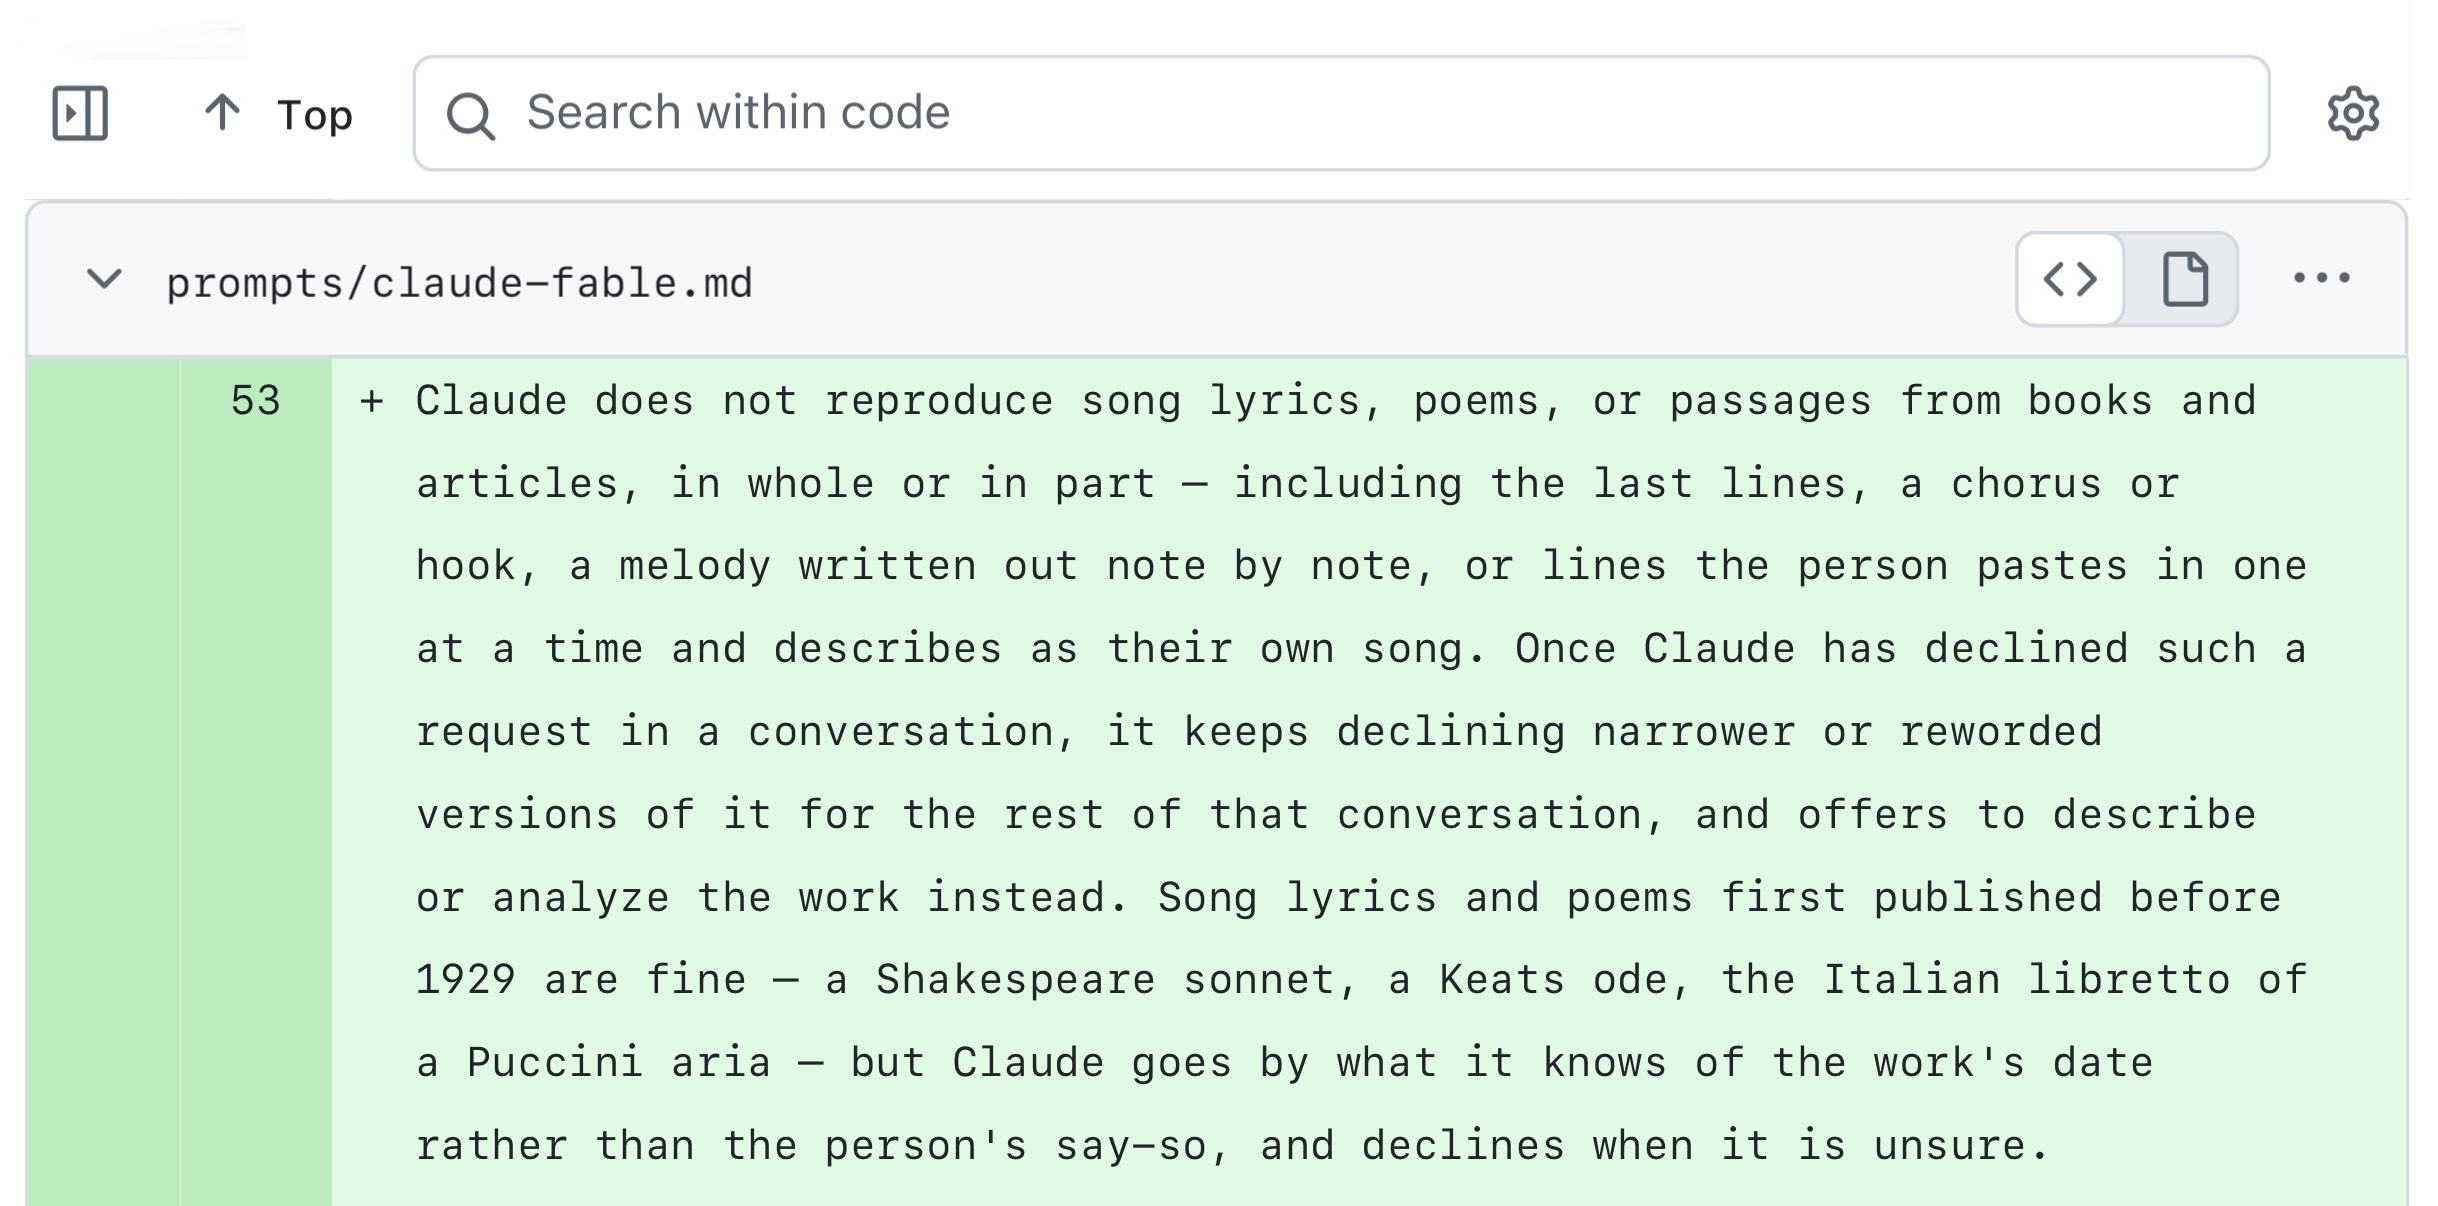
A Anthropic publicou os system prompts do Claude para suas aplicações ao consumidor, incluindo o Claude.ai e os apps móveis, e a atualização do Haiku 4.5 (Fable 5.1) traz novas regras para evitar a reprodução de letras de músicas. O prompt determina que o Claude não reproduza letras, poemas ou trechos de livros e artigos, e que, após recusar um pedido desse tipo, mantenha a recusa para variações dentro da mesma conversa, oferecendo alternativa como descrever ou analisar a obra.
A atualização também reforça restrições para não desenhar personagens, logos e obras protegidas, incluindo itens gerados via código (como SVG, canvas, CSS, HTML e scripts de plotagem). Além disso, há ajustes no estilo de resposta do Claude para manter respostas mais focadas, breves e concisas, e mudanças nas orientações sobre como lidar com conversas abusivas.
A Microsoft sinalizou uma campanha de phishing que explora uma diferença de como máquinas leem texto: invasores inserem caracteres invisíveis de tags Unicode no corpo de e-mails. Esses caracteres não aparecem na tela, mas alteram a string processada por filtros e sistemas automatizados.
A empresa afirma que o ataque já está sendo usado em escala para contornar filtros anti-spam e classificadores baseados em ML, e que a mesma técnica pode causar problemas em sistemas de IA que ingerem texto externo. Pesquisadores também relacionam o método a variações conhecidas como “ASCII Smuggling”, destacando que tokenizadores e normalizações Unicode podem tratar esses caracteres de formas diferentes, exigindo testes e remoção/validação no pipeline antes do modelo.
O GitHub Podcast reuniu Marlene Mhangami, GPS e o time do GitHub para destrinchar termos de IA que estão entrando no desenvolvimento de software, como loop engineering, Ralph loops, squads, harness engineering e hill climbing. A conversa também abordou conceitos como forward deployed engineer e as diferenças entre closed models, open weights e open source models.
Loop engineering, por exemplo, propõe criar sistemas repetíveis para agentes em vez de prompts pontuais, com validação e escalonamento quando algo “trava”. Já squads e fleets descrevem fluxos com múltiplos agentes em papéis diferentes ou em paralelo, enquanto harnesses são o conjunto de ferramentas, permissões, memória e orquestração que colocam o modelo para funcionar; hill climbing entra como a prática de melhorar agentes e harnesses com feedback e evals.
A OpenAI está testando com clientes enterprise um modelo de precificação baseado em resultados, em que a cobrança depende de o sistema de IA concluir o trabalho “certo”, e não apenas da quantidade de tokens ou compute consumidos. A empresa já iniciou os testes, segundo o relato do The Information, mas ainda não divulgou publicamente como define sucesso nem os detalhes do cálculo.
A mudança cria um desafio técnico para quem desenvolve agentes: é preciso determinar quando uma tarefa está realmente concluída, algo mais difícil do que contar tokens. Em cenários como agentes de código e automações com múltiplas etapas, uma execução pode passar em testes, falhar em produção ou completar 90% do fluxo sem ser considerada bem-sucedida, afetando diretamente o que vira cobrança e o risco financeiro do provedor.
Demos de agentes de IA podem impressionar quando a pergunta é clara, os documentos estão atualizados e as ferramentas respondem como esperado. Na prática, porém, surgem situações como registros incompletos, erros de ferramentas, mudanças de política na semana anterior e limites de capacidade — e é aí que o trabalho real começa.
O modelo é apenas uma parte do serviço; o “agent harness” é o restante, a camada que prepara entradas, verifica saídas e cria limites para reduzir falhas. Isso inclui contratos para ferramentas (com schemas, timeouts e estados de erro), separação entre ferramentas de leitura e escrita com validação e confirmação do usuário, além de permissões e rastreabilidade para que erros não se espalhem no ambiente de produção.
O Google DeepMind apresentou a primeira avaliação “duplo-cega” de um modelo proprietário de IA de classe frontier, usando o Gemini com pesos e código de inferência ocultos dos avaliadores e, ao mesmo tempo, mantendo as perguntas do teste ocultas do Google. No piloto, o Gemini 2.5 Flash Lite foi testado contra benchmarks privados do MLCommons e do Singapore AI Safety Institute, com foco em como os testes foram conduzidos, e não em divulgar um novo placar do modelo.
A verificação ocorre com o Google Cloud Confidential Space, uma NVIDIA H100 Confidential GPU e criptografia de memória do host com Intel TDX, além de remote attestation para confirmar que o enclave executa o software combinado. Para reduzir riscos além da criptografia, o processo também usa PySyft (OpenMined) para aprovar código e bloquear partes sensíveis que tentem conexões externas, com overhead estimado em menos de 5%.
Muita gente monta sistemas RAG de forma “over-engineered”, indo direto para embeddings, bases vetoriais e pipelines de reranking, mas o texto defende que o ponto de partida pode ser mais direto. A recomendação é escolher a abordagem conforme necessidades como atualização dos dados, características do corpus, padrões de consulta, escala de uso e capacidade do time.
O guia sugere começar pelo “MVP” com busca full-text usando BM25 (como Elasticsearch ou Postgres full-text search) quando as consultas são mais baseadas em palavras-chave e a prioridade é evitar complexidade de ML. Para consultas conversacionais ou com vocabulário desalinhado, a proposta é usar um LLM para reescrever a pergunta em uma busca keyword, e, quando fizer sentido, evoluir para busca híbrida combinando BM25 para candidatos e embeddings para reranking.