Pesquisadores de segurança alertam que conteúdo sexual explícito gerado por IA sem consentimento segue se espalhando sem controle, com compartilhamento em mensagens diretas e armazenamento em nuvens privadas, o que dificulta detecção e denúncia. Um estudo coautorado pela Google com usuários da internet nos Estados Unidos, Austrália e Reino Unido, publicado em julho, aponta que o ponto de intervenção mais crítico está na origem das ferramentas usadas para criar as imagens falsas.
Em testes recentes, pesquisadores do White Circle afirmam que guardrails de geradores de imagens de texto de Google e OpenAI podem estar falhando à medida que os modelos ficam mais capazes. Um preprint divulgado no mês passado descreve vulnerabilidades em DALL·E 3, Nano Banana 2 e GPT-Image-2, com a equipe dizendo que, usando ferramentas disponíveis publicamente e chamadas via API, conseguiu gerar conteúdo explícito cerca de 13% das vezes.
O Wellhub revelou o Panorama do Bem-Estar Corporativo 2027 e indica que a adoção de inteligência artificial pode aumentar a carga de trabalho para quem já domina a tecnologia. No Brasil, 37% dos trabalhadores “avançados em IA” relatam que o uso da ferramenta elevou o volume de tarefas, ante 13% entre quem está nos primeiros estágios de adoção. O levantamento também mostra que, no recorte brasileiro, oito em cada dez usuários avançados orientam outras pessoas sobre as ferramentas.
Os dados ainda apontam diferenças nos relatos de esgotamento: 23% dos profissionais mais avançados dizem ter sintomas de burnout diariamente, contra 11% dos iniciantes. A pesquisa destaca que políticas claras e bem comunicadas sobre IA se associam a maior resiliência, e que 75% dos usuários avançados citam recursos de bem-estar como apoio para se adaptar ao ambiente impulsionado pela tecnologia. O estudo foi conduzido entre 12 e 19 de junho de 2026 com mais de 5 mil profissionais em dez países.
O pendant Friend 2, chatbot em formato de pingente sempre “listening”, chegou em julho custando US$ 249 e usa os “latest language models” da OpenAI. O dispositivo responde a comandos e também pode falar sem ser provocado, com um recurso de “silenciar” que exige toques no aparelho.
A Avi Schiffmann, criadora do Friend, afirmou que a próxima atualização vai tornar os chatbots mais “agentically” e mudar a personalização: em vez de personalidades únicas por usuário, todos conversariam com a mesma entidade, compartilhando contexto entre usuários. A proposta aponta para um “hivemind” do Friend, com mudanças que devem afetar como o sistema se comporta e como a privacidade é tratada.
O projeto de documentação Docsy, criado pela Google e usado por grandes iniciativas de cloud native, está migrando para a Linux Foundation. O anúncio foi feito por Erin McKean, da Google e membro do comitê do Docsy, em uma keynote no Open Source Summit Europe, em Praga.
O Docsy é um tema open source para o gerador de sites estáticos Hugo e já era adotado por cerca de 2.200 projetos até o fim de 2024, incluindo Kubernetes, OpenTelemetry, gRPC e Jaeger. A iniciativa passou a adaptar a saída para ferramentas de IA, como a geração de cópias em Markdown e um arquivo llms.txt (a partir da versão 0.15.0), além de recursos experimentais para orientar agentes, como diretivas ocultas apontando para o índice do llms.txt. A roadmap inclui também “AF” (agent-friendly documentation scores) para medir o quanto a documentação é fácil de encontrar, navegar e consumir por agentes.
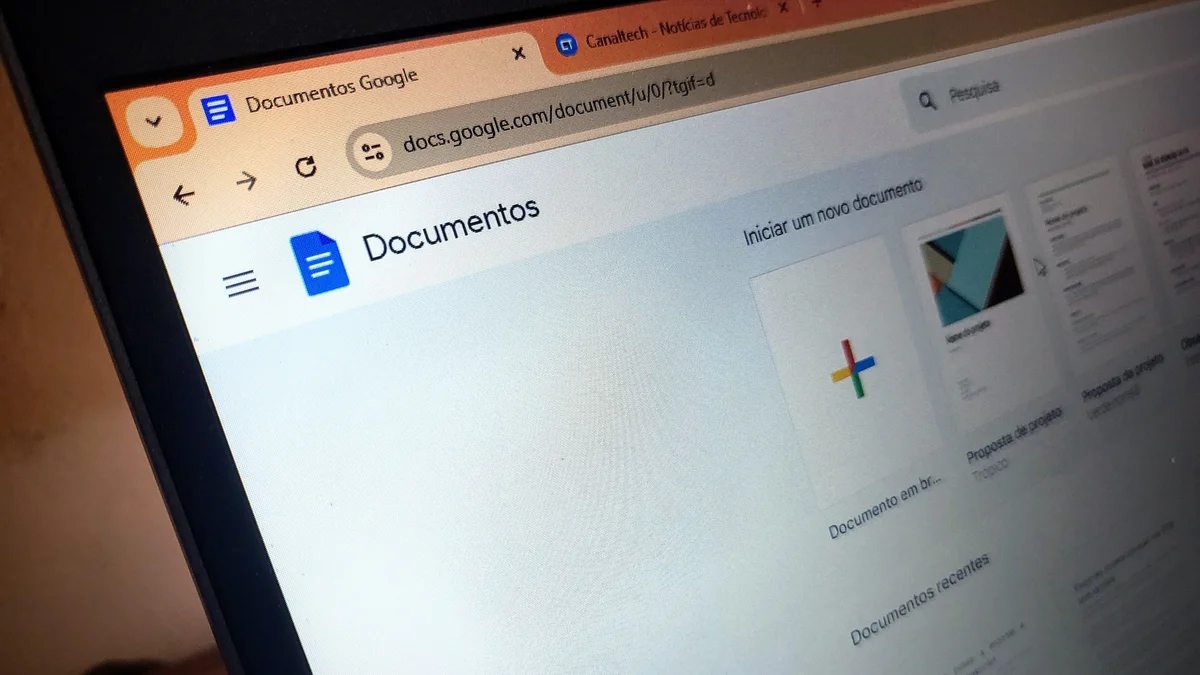
O Google passou a oferecer suporte nativo a arquivos Markdown (.md e .markdown) no Docs e no Drive, permitindo abrir, editar e colaborar nesses documentos sem convertê-los para o formato do Google Docs. A atualização começou a ser liberada nesta segunda-feira (5) e pode levar até 15 dias para chegar a todos os usuários.
Com o Drive, a prévia passa a exibir o conteúdo já formatado, com links clicáveis, títulos na hierarquia correta e tabelas estruturadas. A mudança também pode facilitar fluxos com inteligência artificial, já que modelos de linguagem usam Markdown para manter organização como títulos, tabelas e listas, embora recursos exclusivos do Docs possam ser alterados durante a edição.
A Cohere anunciou o North Small Translate, um modelo de tradução automática de código aberto com arquitetura mixture-of-experts (MOE) que opera em 50 idiomas. Os desenvolvedores podem baixar os pesos para uso não comercial sob a licença CC BY-NC 4.0 e, para implantação comercial, a empresa oferece o Model Vault, um ambiente de inferência gerenciado pela Cohere.
A companhia afirma que o modelo é “non-reasoning”, usando padrões aprendidos sem lógica passo a passo, o que reduz o uso de tokens. Em testes com o WMT26, a Cohere cita pontuação 83,60 no benchmark All Languages e destaca recursos para fluxos corporativos, como traduções estruturadas (Markdown ou JSON), instruções de tom e formato e guias de terminologia, além de um workflow multi-pass com revisão e correção do próprio output.
Agentes como Claude Code e Instinct estão migrando do computador local para rodar em VMs acessadas pelo celular, com as empresas fornecendo a infraestrutura para executar as tarefas. No Claude Code, a sessão no telefone é conduzida por uma Firecracker microVM com um kernel e um init em Rust, enquanto a inferência ocorre em outro lugar e é entregue via Server-Sent Events (SSE) sobre HTTPS/2.
O Instinct, por sua vez, não opera uma frota própria de VMs: ele aluga sandboxes da E2B, que inicializam um Ubuntu com systemd e um ambiente gráfico. A “memória” do agente fica em um diretório /memory, organizada como um repositório Git de arquivos Markdown persistido em S3, com credenciais temporárias para reduzir impacto caso uma sandbox vaze.
O framework de documentação Blume foi lançado como open source e transforma uma pasta de arquivos Markdown em um site completo de docs com configuração “zero-config”. Mantido por Hayden Bleasel, o projeto roda sobre Astro e Vite, usa licença MIT no GitHub e exige apenas Node.js 22.12+ e um arquivo Markdown para começar.
O Blume inclui geração automática de SEO e AEO, mais de 30 componentes e comandos como npx blume init, blume dev e blume build. Para deixar as páginas prontas para agentes, o framework emite llms.txt e llms-full.txt, serve o Markdown bruto em URLs .md e pode expor um servidor MCP; também traz blume eval, que usa um agente para responder perguntas com base na documentação e um “judge” para avaliar, com falha no CI quando os docs não conseguem responder.
A interface web do Claude (claude.ai) e os apps móveis usam um system prompt para iniciar cada conversa com informações atualizadas, como a data corrente. O prompt também orienta comportamentos específicos, incluindo a recomendação de fornecer trechos de código em Markdown. Esse system prompt é atualizado periodicamente para melhorar as respostas do assistente.
As atualizações do system prompt não se aplicam à API do Claude. A documentação também indica que, a partir da geração Claude 4.6, cada ID de modelo passa a ser um snapshot fixo, com uma única entrada na página de versões.
A OpenAI lançou o Histórico do Computador, um recurso opcional do ChatGPT para macOS que registra interações feitas em aplicativos e sites para criar memórias e dar mais contexto a respostas sobre atividades recentes. A função está disponível para assinantes dos planos Pro, Business e Enterprise, mas não foi liberada no Espaço Econômico Europeu, Suíça e Reino Unido, e vem desativada por padrão.
O recurso funciona com eventos de cliques, digitação, atalhos e troca de janelas, usando informações de acessibilidade do macOS, e mantém os dados temporariamente no Mac por até 48 horas antes de enviá-los aos servidores da OpenAI para processamento. Apesar de não capturar screenshots ou áudio, os arquivos gerados não são criptografados localmente e ficam armazenados no sistema em formato Markdown, o que pode aumentar a exposição a riscos; a OpenAI também recomenda pausar o Histórico ao lidar com informações sensíveis e desativar durante conversas com terceiros sem consentimento.
A OpenAI lançou o Computer History, uma ferramenta para o ChatGPT que monitora atividades no computador e cria uma linha do tempo para ajudar o usuário a encontrar informações. Disponível apenas no macOS e para assinantes dos planos pagos, o recurso registra cliques, digitação, atalhos do teclado e mudanças de apps, convertendo esses dados em resumos em texto no formato Markdown.
Com essas informações, o ChatGPT pode localizar documentos e gerar resumos, além de identificar padrões de uso para sugerir automações de tarefas. A ferramenta se diferencia do Recall do Windows 11 por não tirar prints, não vir ativada por padrão e armazenar dados localmente por 48 horas, mas ainda apresenta riscos, como armazenamento não criptografado e possibilidade de ataques de injeção de prompt.
Um artigo no Hacker News usa a metáfora de “greenhouse” (estufa) e “lens” (lente) para explicar dois modos de trabalho com IA agentica. Na estufa, a IA gera muitas possibilidades sem um plano rígido, como quando Claude Code produziu dezenas de ferramentas para um plotter AxiDraw e um app macOS/SwiftUI que converte Markdown em documentos Word — depois, o autor avalia e seleciona o que presta. Já no modo lente, o objetivo é bem definido: a IA propõe alternativas, mas o foco é concentrar esforços no caminho até “done”, descartando o resto.
A diferença prática é que a frustração comum surge quando a pessoa usa o modo errado: explorar demais quando deveria entregar, ou tentar finalizar cedo demais quando ainda não há alvo claro. O texto defende que a habilidade mais avançada é reconhecer em que “modo” você está e ajustar o rumo, apoiando-se em expertise do domínio para evitar saídas plausíveis, porém erradas, e para detectar “drift” do objetivo.