14 resultados para Throughput
Segunda · 12 out
2026-10-12
2 matérias
IA
Destaque

Pesquisa · IA
A Microsoft anunciou a terceira geração do chip de IA Maia, o Maia 300, com foco em atuar como “principal sistema de inferência” para produtos e serviços da empresa. O chip foi projetado para melhorar custo e eficiência na nuvem e para lidar melhor com modelos de raciocínio e tarefas agentic (orientadas por objetivos).
O Maia 300 começa a ser distribuído para cargas de trabalho de produção em 2027. A Microsoft espera entregar 40% mais tokens por megawatt do que sistemas líderes baseados em GPUs e, em uma configuração com 96 aceleradores, até 7x mais throughput em nível de rack do que o Maia 200, que já roda em produção em serviços como Microsoft Copilot e GitHub Copilot.
#InteligenciaArtificial · #IA · #chipsDeIA · #Microsoft · #Maia300 · #Azure · #IAgenerativa
IA
Pesquisa · IA
A evolução da inteligência artificial nas empresas está levando do modelo reativo de perguntas e respostas para a era da IA agêntica, com sistemas formados por múltiplos agentes digitais que raciocinam, consultam bancos de dados, chamam APIs externas e coordenam tarefas em segundo plano. Com isso, a infraestrutura deixa de atender apenas ao funcionamento do modelo e passa a precisar de camadas de orquestração, segurança, gerenciamento de memória, bancos de dados vetoriais, middleware e APIs.
A mudança de paradigma também altera a forma de dimensionar recursos: em vez de uma proporção histórica de 1 CPU para 4 ou 8 GPUs focadas em inferência, cenários de alta concorrência podem fazer a demanda por CPU superar a do acelerador gráfico. A avaliação de capacidade passa a considerar throughput por rack sob restrições reais de energia, conectividade de baixa latência e densidade de núcleos para evitar gargalos de latência e custos operacionais elevados.
#InteligenciaArtificial · #IAagente · #InfraestruturaDeTI · #GPUs · #CPUs · #ArquiteturaDeComputadores · #APIs
Domingo · 20 set
2026-09-20
1 matéria
Eng · Dev com IA
Destaque
Engenharia · Software com IA
O runtime Bun, para JavaScript/TypeScript, foi reescrito de Zig para Rust após quatro meses de trabalho, com o objetivo de reduzir vulnerabilidades de segurança ligadas a falhas de memória. Segundo Jarred Sumner, o uso do borrow checker do Rust ajuda a transformar problemas recorrentes como use-after-free, double-free e “forgot to free” em erros de compilação.
A migração foi feita com apoio de um processo assistido por IA: o time usou um Claude Fable 5 pré-release orquestrado em cerca de 50 fluxos dinâmicos, convertendo arquivos Zig para Rust e validando contra um conjunto de testes de mais de um milhão de asserções. O Bun v1.4.0, lançado em agosto de 2026, afirma ter corrigido 128 bugs antigos do v1.3.14, reduzido vazamentos de memória nativos e melhorado métricas como throughput HTTP em 2% a 5%.
#InteligenciaArtificial · #IA · #DesenvolvimentoDeSoftware · #Rust · #Bun · #Claude · #Programacao
Sexta · 04 set
2026-09-04
1 matéria
IA
Destaque

Pesquisa · IA
O modelo GPT-6 Astra, da OpenAI, foi disponibilizado na OpenRouter como “flagship” para tarefas avançadas de ponta a ponta, incluindo análise, engenharia de software, pesquisa profunda e criação de documentos. Ele é indicado para agentes de IA com uso de computador e navegador ao longo de horizontes longos.
O GPT-6 Astra custa US$ 10 por 1M tokens de entrada e US$ 50 por 1M tokens de saída, com preços separados para Cache Read, Cache Write e Web Search. A OpenRouter roteia as requisições entre provedores (OpenAI e Azure) com modos de balanceamento e failover automático, além de oferecer métricas como throughput, latência e uptime; o lançamento ocorreu em 4 de setembro de 2026.
#InteligenciaArtificial · #IA · #IAgenerativa · #OpenRouter · #OpenAI · #LLM · #AgentesDeIA
Quinta · 03 set
2026-09-03
1 matéria
Eng · Dev com IA
Destaque
Engenharia · Software com IA
A Shopify apresentou o Gisting, uma técnica para comprimir prompts longos de LLM em um conjunto menor de tokens “gist” aprendidos, com foco em aumentar o throughput e reduzir o custo de inferência. A empresa afirma que, durante o uso, a substituição do texto extenso por gist tokens reduz a latência ponta a ponta e melhora a taxa de processamento sem alterar os pesos centrais do modelo.
No Sidekick, o sistema prompt caiu de cerca de 6.000 tokens para 1.500 gist tokens, mantendo a qualidade das previsões. Com 350 requests por minuto, o tempo para o primeiro token (TTFT) passou de 438 ms para 354 ms, a latência end-to-end caiu de 6,8 s para 4,2 s e o throughput subiu de 20,2 para 23,4 QPS, permitindo reduzir a alocação de GPUs.
#InteligenciaArtificial · #IAgenerativa · #LLM · #PromptEngineering · #DesenvolvimentoDeSoftware · #InferenciaDeIA · #Tokenization
Terça · 01 set
2026-09-01
1 matéria
IA
Destaque
Pesquisa · IA
A indústria de IA usa o conceito de “efficient frontier” para descrever tradeoffs entre custo e capacidade dos modelos, e aplica a mesma lógica à inferência. Na prática, engenheiros de inferência ajustam pontos do sistema entre latência e throughput para reduzir custos, ou trocam qualidade por throughput com técnicas como quantização, distilação e poda.
O texto também separa abordagens que apenas movem o deployment ao longo da fronteira das que empurram a fronteira inteira, liberando mais eficiência para decidir onde alocar ganhos. Entre os exemplos citados estão batch sizing, estratégias de paralelismo (como Tensor Parallelism, Expert Parallelism e Attention Data Parallelism), além de otimizações de kernels e runtime e o uso de speculative decoding para aumentar desempenho no ciclo de geração.
#InteligenciaArtificial · #IA · #LLM · #InferenciaDeLLM · #Quantizacao · #Latencia · #Throughput
Sexta · 21 ago
2026-08-21
1 matéria
IA
Pesquisa · IA
O CTO da Huawei Cloud na América Latina, Bin Duan, afirma que comparar modelos de IA apenas pelo preço por token é uma forma incompleta de estimar gastos. Ele diz que o custo de uma aplicação depende de variáveis como tokens de entrada e saída, tamanho do contexto, uso de cache, volume de chamadas e complexidade da tarefa, o que pode levar a economias de até 80% e 89% conforme o cenário.
A lógica sustenta o Model as a Service (MaaS), que oferece acesso a diferentes modelos de IA por uma infraestrutura em nuvem. A Huawei também prevê desconto de 30% em horário de menor demanda para os modelos GLM 5.1 e GLM 5.2, além de integrar capacidade computacional, software de IA e operações em nuvem, com avaliação por latência, throughput, estabilidade, custo e qualidade do resultado.
#InteligenciaArtificial · #IA · #HuaweiCloud · #ModelasAService · #MaaS · #IAgenerativa · #CloudComputing
Quinta · 20 ago
2026-08-20
1 matéria
IA

Pesquisa · IA
A Stripe concordou em adquirir a OpenRouter, uma plataforma de roteamento de modelos de IA que permite que desenvolvedores acessem centenas de modelos por uma única interface. Segundo a Stripe, a OpenRouter oferece suporte a mais de 400 modelos de mais de 80 provedores, permitindo enviar requisições por uma só API sem integrações separadas com cada fornecedor.
A plataforma avalia requisições com base em fatores como complexidade da tarefa, preço, velocidade e confiabilidade, direcionando cada pedido ao modelo mais adequado. Além disso, faz uma segunda camada de roteamento entre provedores que atendem ao mesmo modelo, com suporte a critérios como custo, throughput e latência, além de failover quando endpoints ficam indisponíveis, e integra isso ao trabalho da Stripe com uso de IA e cobrança baseada em tokens.
#InteligenciaArtificial · #IA · #OpenRouter · #Stripe · #LLM · #ModelRouting · #TokenBilling
Segunda · 17 ago
2026-08-17
1 matéria
IA
Destaque

Pesquisa · IA
O modelo GPT-5.6 Sol, da série GPT-5.6 da OpenAI, passou a ter preço 50% menor no OpenRouter, com valores de US$ 2,50 de entrada e US$ 15 por 1M de contexto. O modelo é descrito como voltado a raciocínio complexo, tarefas de codificação e fluxos com agentes, com destaque para atividades no terminal e problemas de múltiplas etapas.
O OpenRouter também destaca métricas de desempenho como throughput de 36 tokens por segundo e latência de 3,25s no P50, além de disponibilidade monitorada por provedores. A plataforma roteia as requisições entre diferentes empresas conforme o modo escolhido (Balanced, Nitro ou Exacto) e pode redirecionar para um provedor saudável quando ocorre erro.
#InteligenciaArtificial · #IA · #OpenRouter · #GPT-5.6 · #IAgenerativa · #AgentesDeIA · #Programacao
Sexta · 14 ago
2026-08-14
1 matéria
Eng · Dev com IA
Engenharia · Software com IA
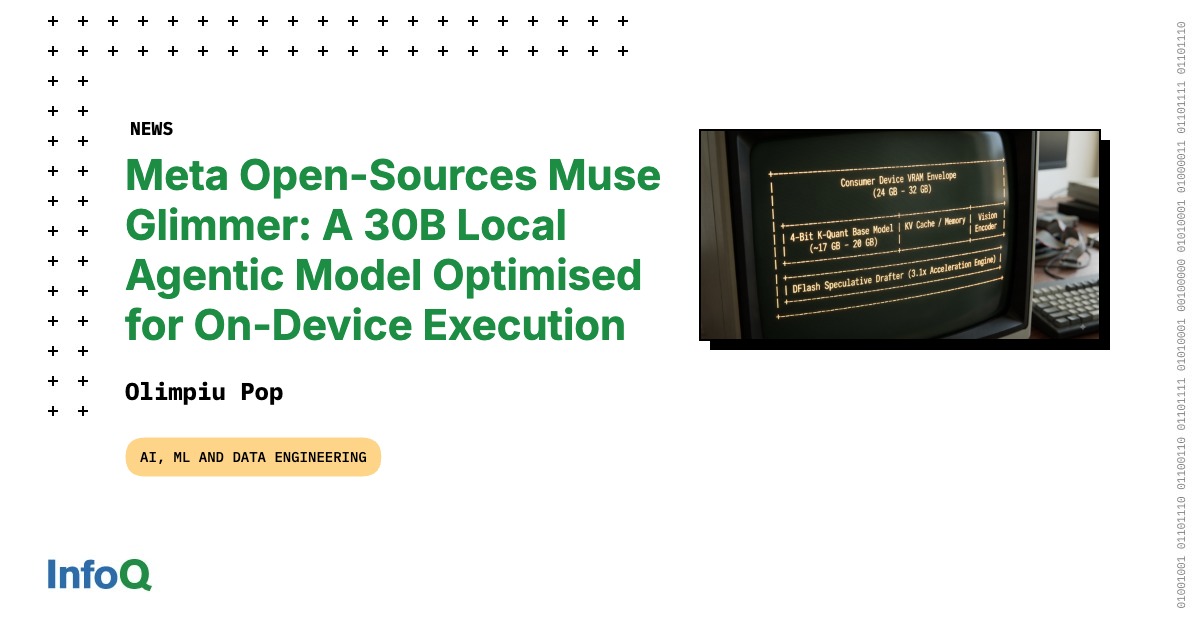
A Meta AI Research lançou o Muse Glimmer, um modelo open-weight de 30 bilhões de parâmetros sob licença Apache 2.0. Projetado para execução local “always-on”, ele permite que desenvolvedores rodem agentes autônomos, invocação complexa de ferramentas, execução de código e avaliações “LLM-as-a-judge” diretamente em GPUs e workstations, sem depender de APIs em nuvem.
Para caber em orçamentos de memória de hardware comum, o Muse Glimmer usa quantização dinâmica 4-bit para reduzir o tamanho para cerca de 17 GB a 20 GB e combina um “drafter” DFlash para validar blocos com múltiplos tokens em paralelo, com ganhos de throughput reportados de até 3,1x. O modelo também inclui um encoder de percepção de 1,8B para inputs multimodais e foi treinado para diagnosticar falhas (como erros de chamadas de API ou comandos no terminal) e tentar caminhos alternativos, com suporte a frameworks como OpenClaw.
#InteligenciaArtificial · #IA · #AgentesDeIA · #ModelosLocais · #LLM · #OpenSource · #DesenvolvimentoDeSoftware
Quinta · 06 ago
2026-08-06
2 matérias
IA
Pesquisa · IA
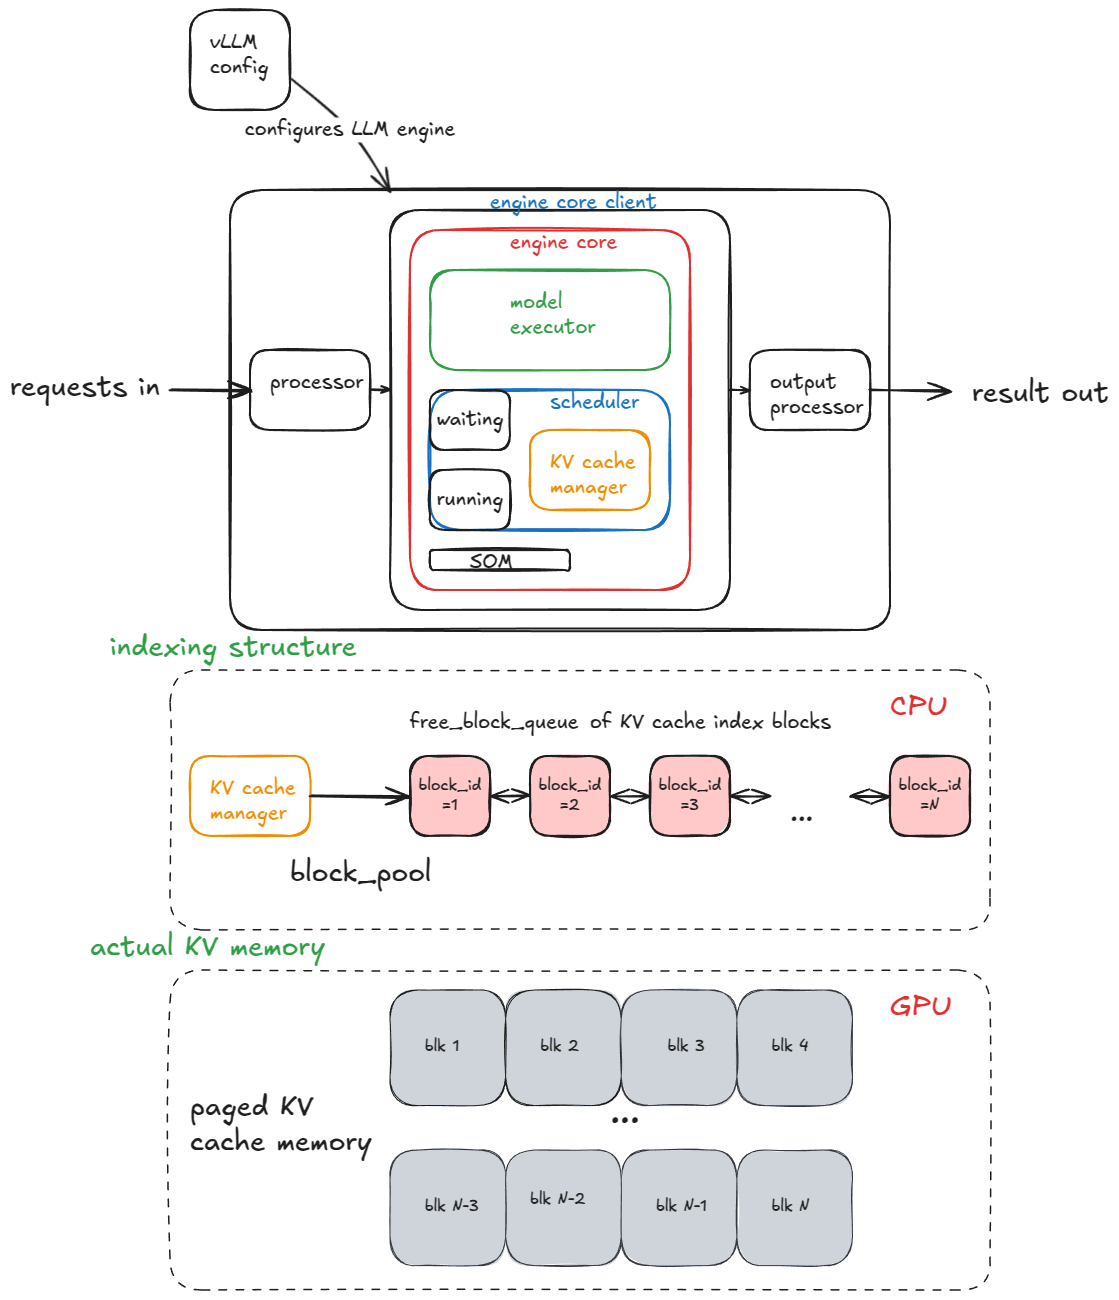
Um post técnico do blog Inside vLLM detalha a anatomia de um sistema moderno de inferência para LLMs com alta taxa de throughput. O autor explica como o vLLM organiza a engine (config, processadores de entrada/saída e o EngineCore), o papel do scheduler (FCFS ou prioridade), e o funcionamento do KV cache manager por paged attention, com blocos de cache mapeando tokens para KV já calculados.
A matéria também descreve o caminho de inicialização do worker (alocação de GPU, validação de VRAM, carregamento de pesos, criação e dimensionamento do KV cache e uso opcional de torch.compile) e como o sistema prepara metadados de atenção e CUDA graphs para reduzir overhead. Na prática, isso ajuda times de dev/infra a entender gargalos e otimizações que impactam latência e custo em produção ao servir modelos em escala.
#vLLM · #LLM inference · #KV cache · #paged attention · #CUDA graphs · #high throughput
Eng · Dev com IA
Engenharia · Software com IA
Uma apresentação do lead engineer Dumanshu Goyal, da Airbnb, usa a história do programa do Ônibus Espacial da NASA para defender “design para eficiência” e aplicar a mesma lógica a sistemas modernos de IA. O ponto central é que, na prática, requisitos pouco revisados podem inflar custos e complexidade — como ocorreu com as milhares de telhas de sílica no Ônibus Espacial — enquanto uma análise rigorosa de requisitos e trade-offs leva a soluções mais simples e eficientes.
No contexto de IA, o talk conecta essa mentalidade ao uso de OSS Valkey e a padrões de arquitetura voltados a reduzir latência e melhorar throughput, especialmente quando a meta deixa de ser milissegundos e passa a ser microsegundos. Para devs, isso reforça a importância de projetar camadas de dados e cache com observabilidade e decisões de engenharia orientadas por desempenho real, que impacta diretamente aplicações de IA em tempo quase real.
#Valkey · #arquitetura de software · #latência · #cache · #AI performance · #open source · #data platform
Quarta · 05 ago
2026-08-05
1 matéria
IA
Pesquisa · IA
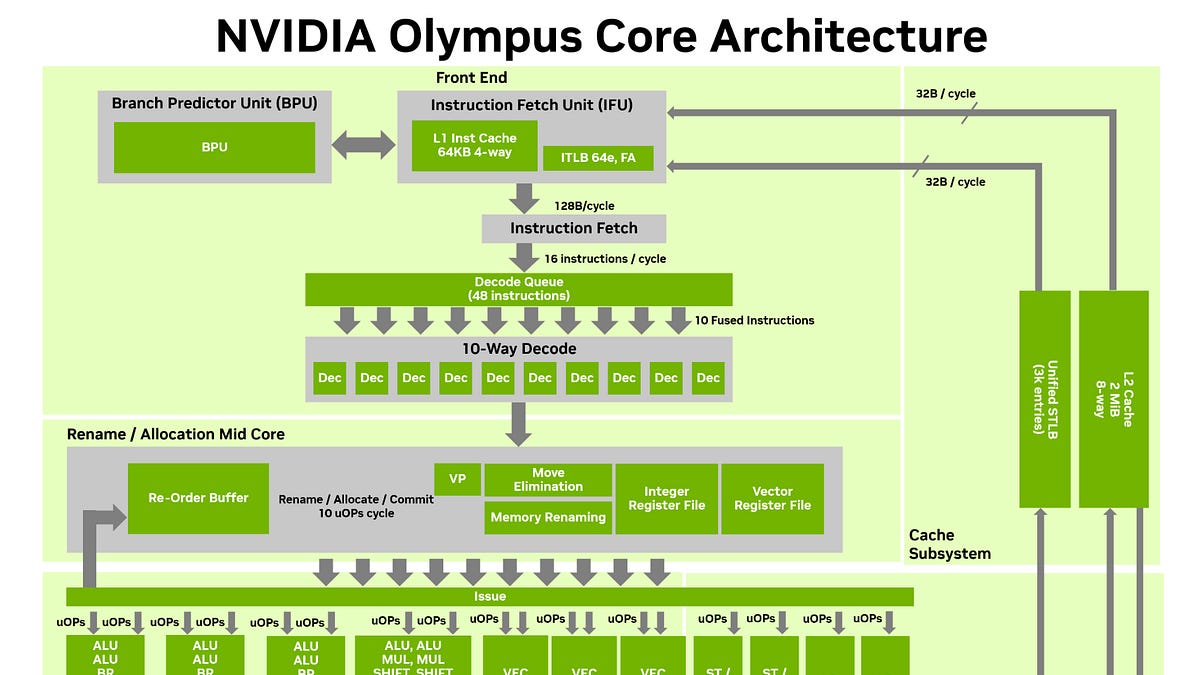
A NVIDIA publicou um whitepaper de 45 páginas sobre a Vera, seu primeiro CPU de servidor baseado no core Olympus (Arm v9.2). O chip traz 88 núcleos em um die monolítico, com cache compartilhado de 164 MB, L2 privado de 2 MB por núcleo e oito interfaces LPDDR5X com promessa de até 1,2 TB/s. Apesar do detalhamento técnico, o documento foi alvo de críticas: o texto tenta sustentar uma narrativa comparando x86 e Arm com exemplos como “benchmarks agentic” e resultados atribuídos a reforço por aprendizado, enquanto análises independentes sugerem que o hardware por si só já é forte.
Testes iniciais do Phoronix, em maio, colocaram o desempenho do Vera acima de CPUs Arm e x86 dentro do conjunto permitido pela NVIDIA: cerca de 10% acima do EPYC 9575F (média geométrica), 1,55x do Xeon 6980P e 1,63x do Grace. Para o público tech, isso importa porque reforça a chegada de uma nova plataforma de servidor com foco em throughput e eficiência — mas também mostra que, para avaliar impacto real, é essencial olhar além do “storytelling” e acompanhar medições independentes em condições mais amplas.
#NVIDIA · #Vera · #CPU · #Armv9 · #servercomputing · #performance · #whitepaper
Terça · 04 ago
2026-08-04
1 matéria
Eng · Dev com IA
Destaque
Engenharia · Software com IA
A cofundadora e CEO da Quotient, Lizzie Matusov, apresentou um framework para entender a “maturidade de IA” em organizações de engenharia e os gargalos que travam resultados no ciclo de vida do software. Ela citou dados como crescimento de 47% no gasto global com IA em 2026 (ano contra ano), projeção de US$ 2,5 trilhões e que 72% das empresas já rodam ao menos um workload de IA em produção. No debate sobre ROI, Matusov mencionou casos como a Uber, que teria consumido o orçamento de IA de 2026 em quatro meses, e a Microsoft, que planeja descontinuar o Claude Code por questões de orçamento e falta de relação estável entre custo e produtividade.
A tese central é que, mesmo com ganhos individuais de produtividade, a entrega ponta a ponta pode não melhorar se o sistema tiver um gargalo (ex.: code review, testes ou deploy) — o que aumenta WIP, alonga lead time e piora a qualidade. Para times de dev, a implicação prática é tratar IA no SDLC como mudança de processo e engenharia: identificar onde o fluxo trava e só então expandir o uso de IA para destravar throughput com qualidade.
#AI maturity model · #SDLC · #code review · #software delivery · #bottlenecks · #DORA report