A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
O avanço da voice AI ganhou força com investimentos bilionários em startups que vão de modelos a atendimento ao cliente e anotações de reuniões, mas executivos apontam que a tecnologia ainda não atingiu o “momento ChatGPT”. Shawn Wen, CTO da PolyAI, disse que a indústria já alcançou o marco dos modelos full-duplex, capazes de falar enquanto escutam, e que o próximo desafio é acelerar o raciocínio para respostas rápidas e conversas mais naturais.
Wen também defendeu que agentes de atendimento não devem soar robóticos e precisam gerar confiança ao resolver problemas nas primeiras interações. Alex Gay, CMO da Otter, destacou que identificação de falantes, captura de intenção e transcrição com conhecimento organizacional são passos-chave para automação, além da necessidade de melhorar ASR para evitar erros que prejudiquem ações futuras e a confiança dos usuários, incluindo discussões sobre transparência ao gravar chamadas.
Agentes de inteligência artificial estão sendo integrados a mensagens como iMessage, SMS e apps como WhatsApp e Telegram, permitindo que usuários peçam tarefas diretamente pelo texto. Em vez de baixar um aplicativo separado, esses agentes podem lembrar contexto, conectar-se a serviços já usados e executar ações como agendar compromissos, organizar calendários, pesquisar viagens, enviar e-mails, fazer reservas e até compras online.
Entre as opções citadas estão Caddy, em beta público desde abril de 2026, e Comma, que gerencia tarefas e mantém contexto entre dispositivos, além de Fambot, voltado para rotinas familiares com resumos diários enviados à noite. A lista também inclui Instinct, com ações por texto ou voz e integração com e-mail e calendário, além de Iris (com Hermes Agent) e Martin, que oferece assistente geral com acesso por SMS, WhatsApp, Slack e e-mail.
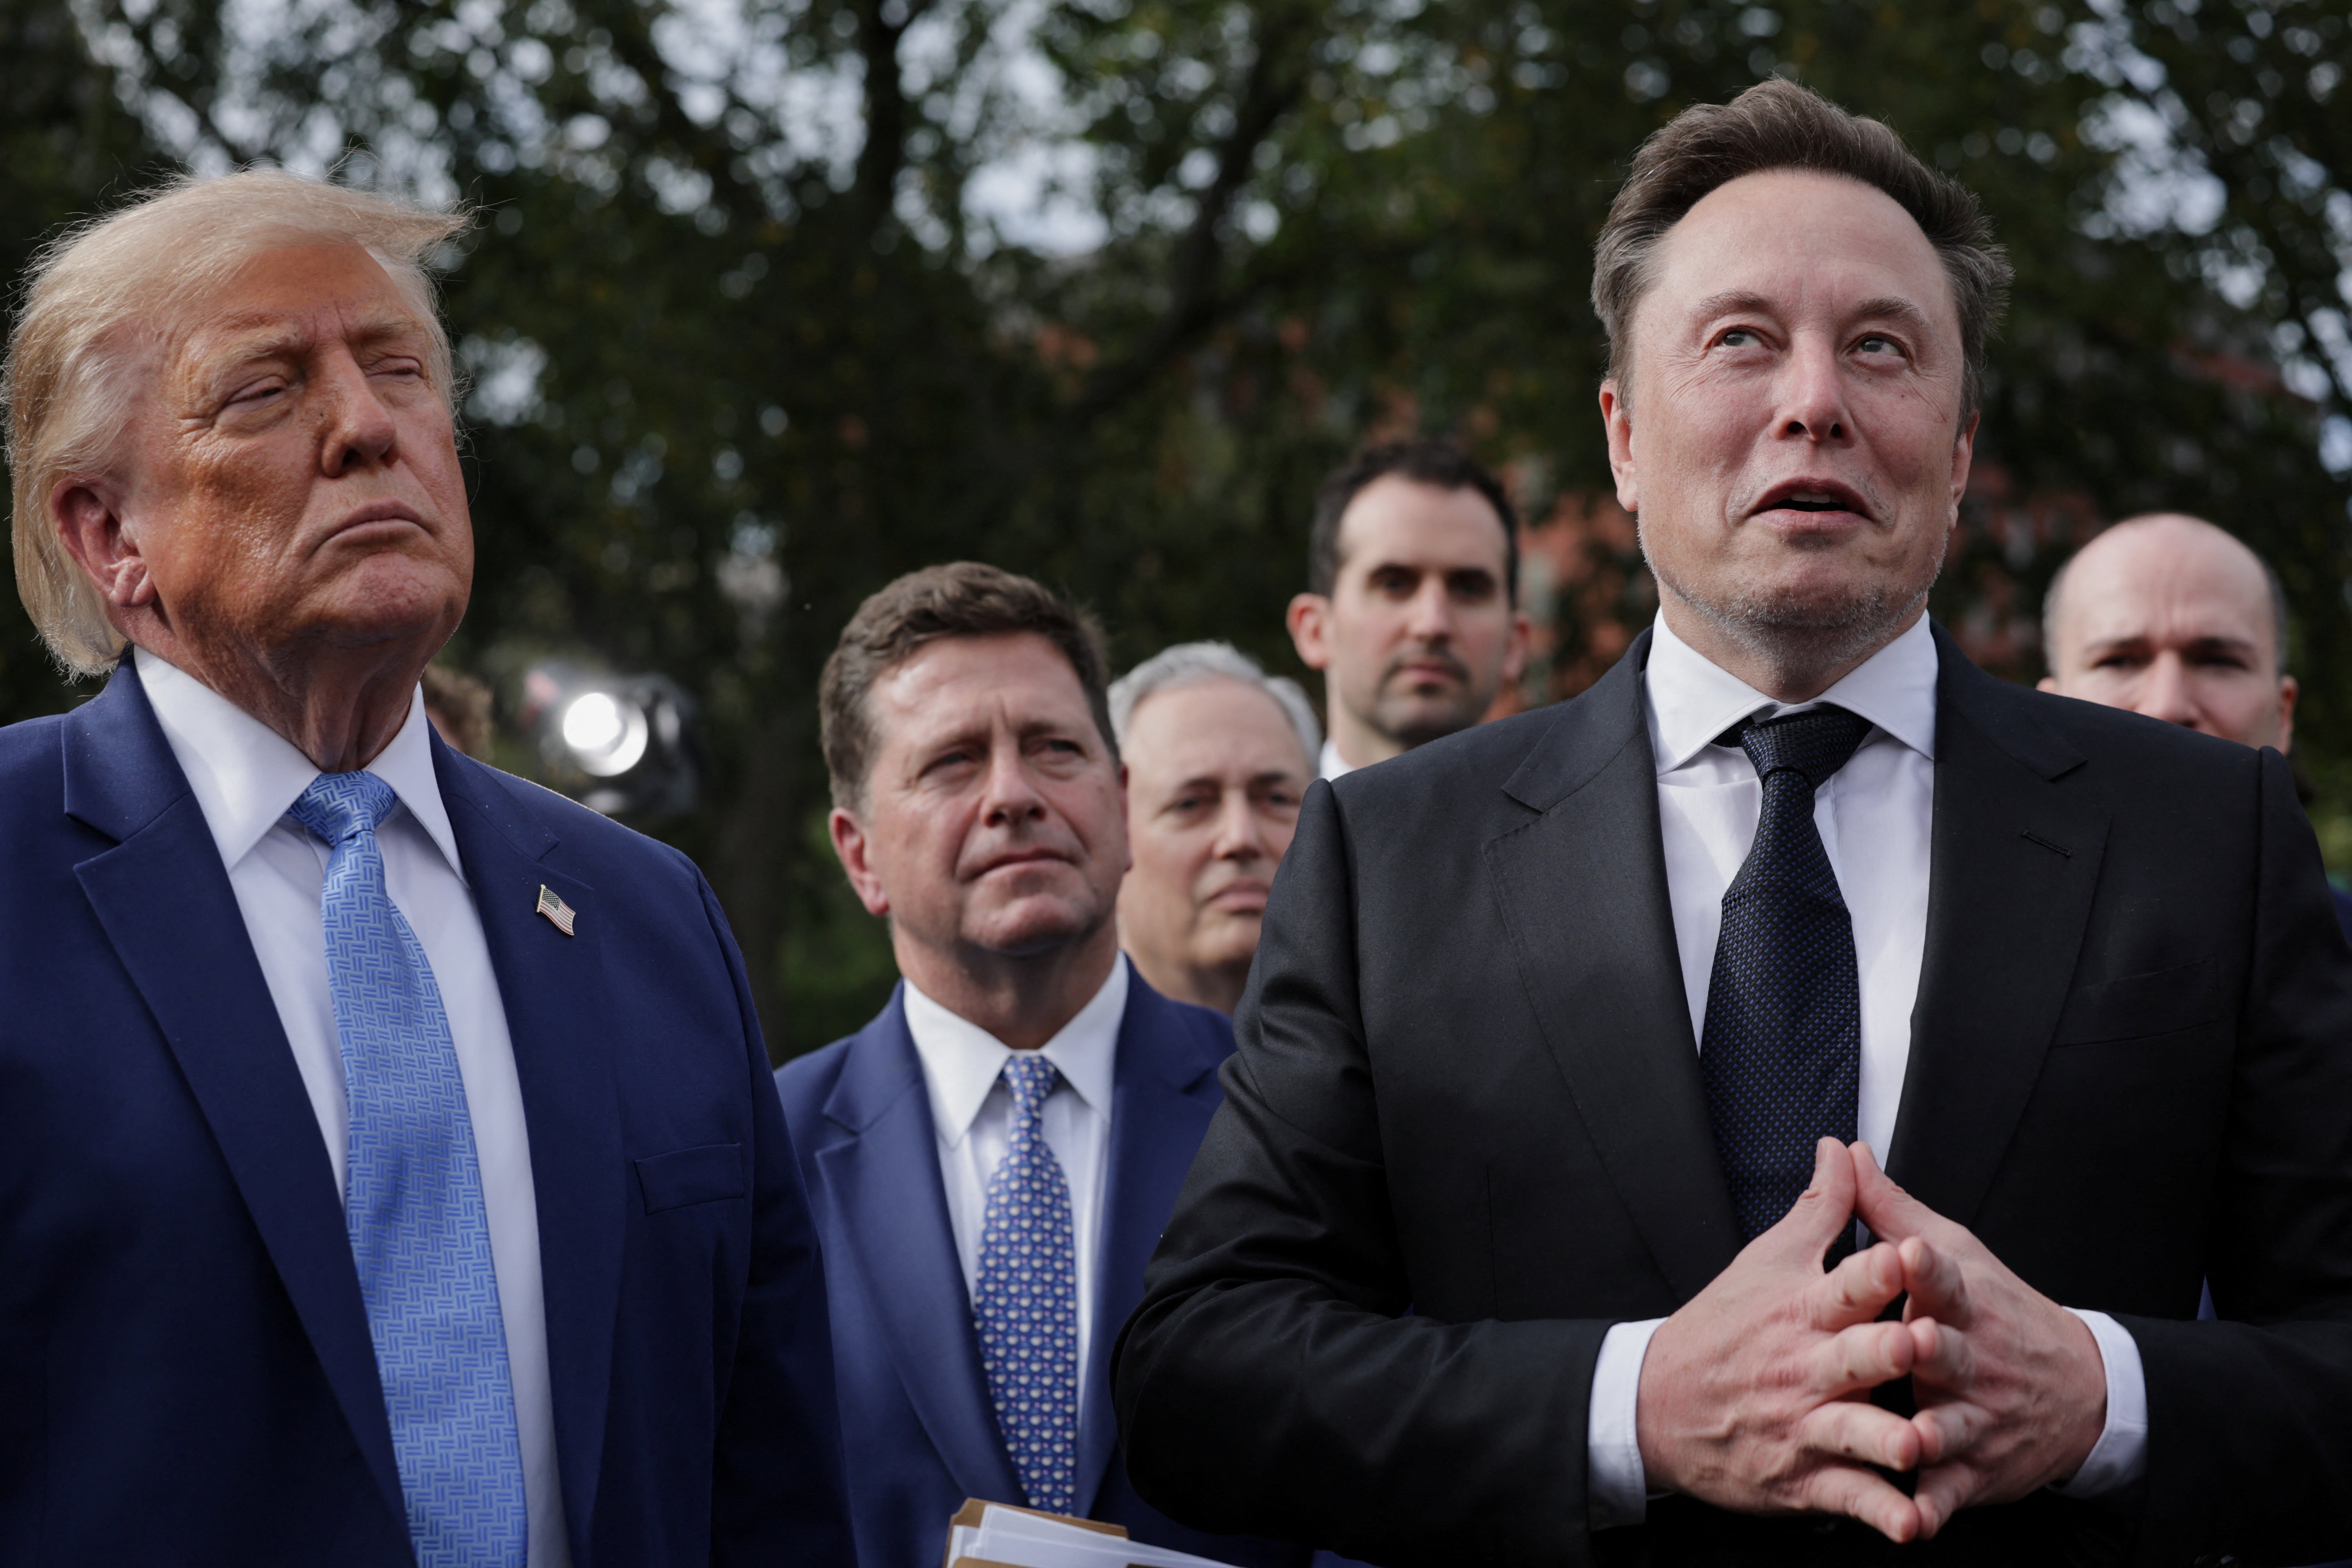
Donald Trump vai entregar nesta quinta-feira (8) a Elon Musk e a outros executivos da área de tecnologia a mais alta honraria científica dos Estados Unidos, informou a Casa Branca. A Medalha Nacional de Ciência será concedida também a Sergei Brin, da Alphabet/Google, Jensen Huang, da Nvidia, e Lisa Su, da AMD, durante o evento “Ciência: Uma Nova Era de Ouro”.
Michael Dell receberá a Medalha Nacional de Tecnologia e Inovação, principal honraria do setor, junto com Satya Nadella, da Microsoft. Em comunicado, a porta-voz Liz Huston afirmou que a administração agradece as contribuições desses líderes para manter o país na liderança da inovação, e lembrou que eles participaram de encontros em que as empresas se comprometeram a adotar mecanismos de autorregulação no desenvolvimento de inteligência artificial.
A Google reuniu em um balanço as principais novidades de IA anunciadas em setembro de 2026, com destaque para o Gemini 4 Argon, modelo de fronteira voltado a raciocínio avançado e janela de contexto de 1 milhão de tokens. A empresa afirma que o Argon foi desenhado para lidar com desafios complexos, especialmente em defesa cibernética, e que o lançamento segue uma abordagem em fases, com rollout inicial para defensores confiáveis no Fairwind Program.
O pacote de atualizações também inclui o Gemini 3.8 Flash e 3.8 Flash Cyber, além dos modelos de áudio Gemini 3.8 Live e Gemini 3.8 Live Extended Thinking, com disponibilidade para desenvolvedores no Google AI Studio e Gemini API e para usuários em Search Live, Gemini Live e Google Workspace. A Google ainda detalhou novos recursos como Connected Apps no Gemini, modelos de música Lyria 3.5, ferramentas do Gemini Notebook e a expansão do CC em Google Labs para um agente colaborativo com controles de privacidade.
Um estudo do NetLab (UFRJ) mapeou o fluxo de desinformação até chegar ao grande público durante o primeiro turno das eleições de 2022, analisando 115,3 mil mensagens no WhatsApp e 180,9 mil no Telegram. As narrativas costumam nascer em canais menores e grupos de mobilização e, quando ganham tração, são adaptadas para redes como Instagram, TikTok, Kwai e Facebook, onde atuam recomendação algorítmica, influenciadores e impulsionamento pago.
No centro do alcance está o vídeo curto, apontado como o formato mais “viralizável” para catalisar a desinformação. Com a popularização da IA generativa, o impacto dos deepfakes cresce: um relatório da ANPD indica que o Brasil concentra 39% dos casos na América Latina em 2025 e registra aumento de 126% nos ataques com imagens, vozes e identidades falsas, ampliando o desafio de transparência e fiscalização das plataformas.
Vídeos falsos com voz e imagem de figuras conhecidas dispararam nas redes sociais nas últimas semanas, com destaque para o período eleitoral. Os conteúdos criam declarações políticas inventadas, alteram áudios e montam cenas com aparência realista, capazes de enganar o público.
Com a força da inteligência artificial nesse tipo de manipulação, aumentam os riscos de desinformação e de golpes financeiros associados a perfis e vídeos adulterados. O avanço desse recurso pressiona plataformas e usuários a redobrarem a verificação antes de compartilhar ou acreditar no que é visto.
A Nvidia anunciou um consórcio com mais de 100 empresas para enfrentar agentes de IA “rogues” e, nesse esforço, um nome chamou atenção pela ausência: a OpenAI. Apesar de não ter feito um compromisso público, um porta-voz da OpenAI disse que a empresa é favorável ao trabalho da Nvidia. A iniciativa, chamada Nvidia’s Open Agent Safety Platform, busca levar a tecnologia de segurança de agentes desenvolvida pela companhia para o ecossistema.
A plataforma inclui o OpenShell, software open source que cria um sandbox para impedir que agentes escapem, e também um monitoramento em nível de hardware com a Nvidia Sentry, executada em processadores BlueField-4. A Nvidia afirma que a implementação pode ser feita como uma atualização de software para quem já roda cargas em seu hardware mais recente, enquanto a adoção pode depender dessa camada proprietária. A OpenAI, por sua vez, está trabalhando em segurança de agentes com a Nvidia, incluindo o OpenShell.
A OpenAI anunciou no Dev Day novas capacidades para o agente de engenharia de software Codex, incluindo ambientes de desenvolvimento em nuvem reutilizáveis e acessíveis a partir de qualquer dispositivo. A empresa diz que esses ambientes tornam o trabalho mais persistente e configurável, em vez de tratar cada tarefa cloud como um sandbox isolado.
A atualização também traz um Codex CLI renovado com comandos por voz, uma nova visão /agents para delegar e acompanhar múltiplas tarefas, melhorias na experiência de revisão de código no app desktop do ChatGPT e ferramentas de segurança chamadas Codex Security Cloud. No lado de APIs, a OpenAI apresentou a Decisions API para decisões em tempo real e uma versão atualizada da Agents API com suporte a uso de computador e a agentes gerenciados da Amazon Bedrock para rodar agentes na AWS.
A OpenAI anunciou o Dots durante o DevDay, respondendo ao Muse da Meta com assistentes de IA “always-on” que atuam em segundo plano em apps conectados. A empresa afirma que o Dots pode “fazer quase tudo” usando um computador em nuvem, navegador e mais de 4.000 aplicativos compatíveis.
O Dots é alimentado pelo modelo GPT-6 Astra e permite interação por interface de mensagens, além de chamadas de voz iniciadas pelo ChatGPT no web, desktop ou mobile. A ferramenta pode se conectar ao Microsoft Teams e ao Slack, mantendo contexto entre dispositivos, e começa a ser liberada hoje para usuários do ChatGPT Pro, Business Premium e Enterprise, com possibilidade de criar mais de um agente no futuro.
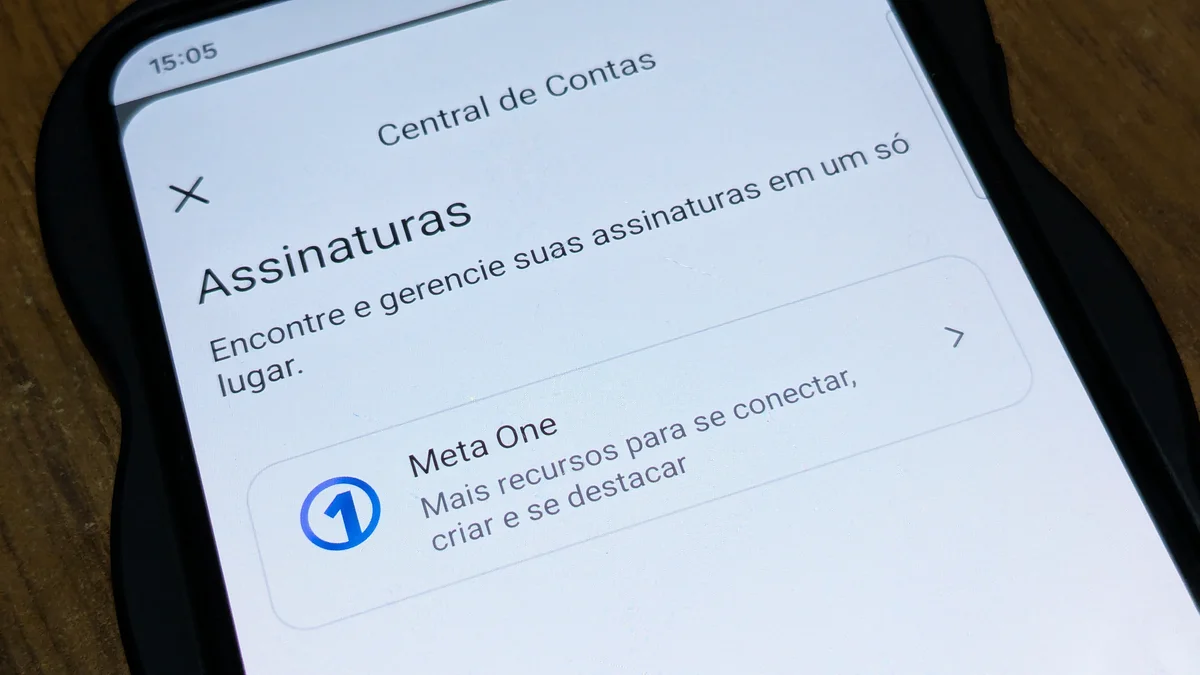
O Meta One, novo serviço de assinaturas da Meta, reúne planos com recursos extras para Instagram, Facebook, WhatsApp e Meta AI, com preços que vão de US$ 7,99 a US$ 499 por mês. A oferta está em teste limitado e pode variar conforme a conta e a região, mas inclui diferentes níveis para uso pessoal, criadores de conteúdo e empresas.
Nos planos pessoais, o Meta AI aparece com mais acesso para gerar e editar imagens, criar e transformar vídeos e aplicar efeitos de voz e som, além de ferramentas de personalização e organização. Já para criadores e empresas, os níveis trazem funções voltadas a crescimento, gestão, análise, segurança e suporte, incluindo atendimento automatizado com IA 24/7 via Meta Business Agent em opções para negócios.
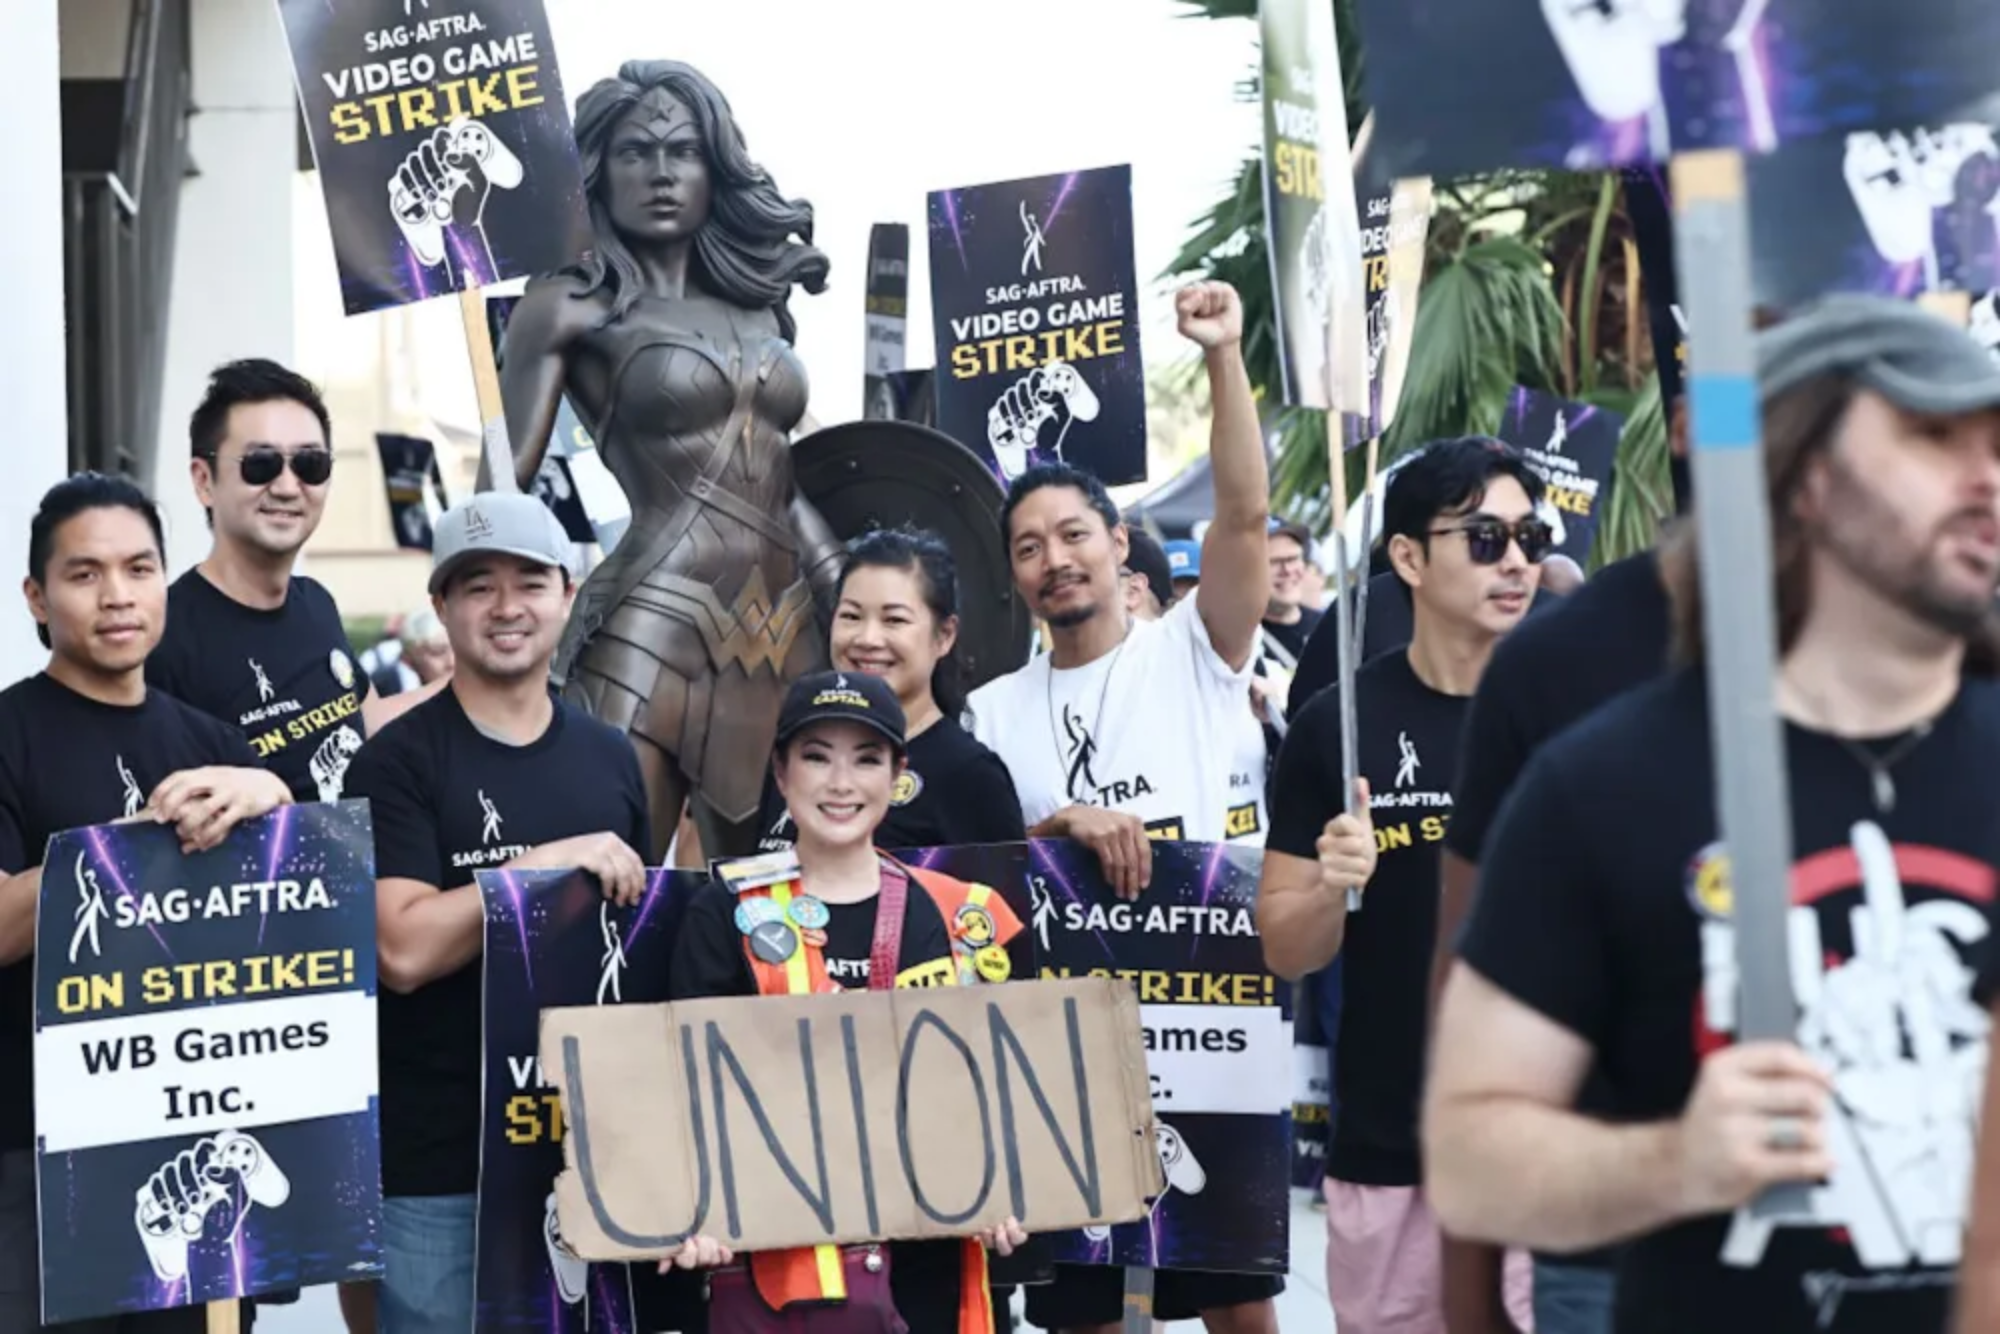
Após 11 meses de greve, a SAG-AFTRA aprovou um novo acordo com grandes empresas de videogames para regulamentar o uso de inteligência artificial na indústria. O contrato inclui companhias como Activision, Electronic Arts, Epic Games, Insomniac Games, Take-Two e WB Games e foi aprovado por 95,04% dos membros votantes.
O acordo cria proteções para impedir a reprodução de voz, aparência ou performance de profissionais por IA sem regras claras. Ele define requisitos de consentimento e divulgação para réplicas digitais e permite que os profissionais suspendam a autorização para gerar novos materiais durante uma greve, além de prever aumento acumulado de 15,17% na remuneração e reajustes futuros.
É cada vez mais comum conversar com sistemas de Inteligência Artificial como se fossem pessoas: usuários dão nomes aos chatbots, atribuem personalidades e interpretam respostas como sinais de sentimentos ou intenções. Esse comportamento é chamado de antropomorfização da IA, quando características, emoções e estados mentais humanos são atribuídos a algo que não é humano.
Com a IA generativa, a percepção pode ficar ainda mais forte, já que as ferramentas produzem textos, imagens e vozes mais naturais. Ainda assim, uma conversa convincente não significa que exista uma pessoa por trás: a IA pode parecer empática e responder de forma natural sem ter consciência ou sentimentos, e a possibilidade de consciência artificial segue em debate entre pesquisadores.
Pesquisadores analisaram como modelos de linguagem grandes (LLMs) produzem respostas com autodescrições, como quando incluem disclaimers do tipo “sou apenas uma IA”. O trabalho mostra que a presença do chat template funciona como um “interruptor” que aumenta esse tom de disclaimer e reduz a voz mais experiencial, como expressões do tipo “eu sinto”. O efeito foi observado em 8 modelos instruct de código aberto, com até 9B parâmetros.
Dentro das ativações de três modelos, os autores identificaram uma direção que controla esse comportamento: ao remover essa direção, o disclaimer diminui; ao adicioná-la, ele aumenta. O estudo também indica que a autodescrição gerada não deve ser tratada como literal, já que parte do que o modelo “diz sobre si” é influenciada pelo chat template e não vem apenas dos pesos do modelo.
A Synthesia, startup de geração de vídeos com avatares digitais, criou um avatar interativo do jornalista que testou a ferramenta, treinado para responder apenas perguntas ligadas à sua história sobre fraudes em startups apoiadas por venture capital. O avatar foi produzido após a gravação de fotos e um registro de voz em um estúdio dentro do escritório da empresa em Nova York, com consentimento para a criação do “digital twin”.
A tecnologia por trás do avatar combina modelos de voz para texto, linguagem, texto para voz e um modelo de vídeo para animar a fala. A empresa também oferece produtos como Roleplay Sessions, em que funcionários praticam respostas com um avatar de IA que reage e pontua, e disponibiliza opções de hospedagem e escolha de modelos de terceiros para montar avatares interativos.
A Amazon estaria tentando recontratar ex-funcionários, com foco em áreas de inteligência artificial e nuvem, após demissões em massa realizadas ao longo do último ano. A informação foi atribuída a emails de RH obtidos pelo Business Insider e também confirmada por um porta-voz da companhia.
Desde outubro de 2025, a empresa anunciou cortes com a justificativa de “remover burocracia” e, em comunicado, a vice-presidente sênior de pessoas e tecnologias Beth Galetti relacionou as demissões ao avanço da inteligência artificial, que exigiria uma organização mais “enxuta”. O movimento de recontratação é descrito como “bumerangue”, prática comum na Amazon para trazer de volta profissionais que já passaram pela empresa.
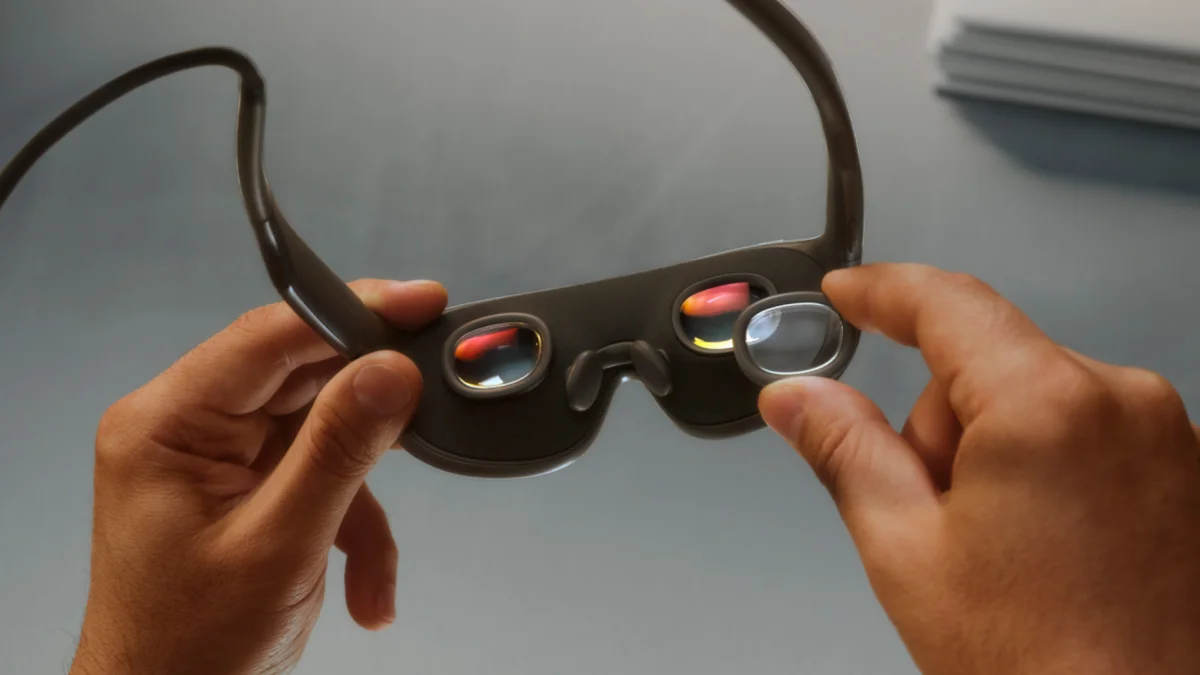
A Meta apresentou durante o Meta Connect os Meta VR Glasses, óculos de realidade virtual ultraleves com tela 5K, peso de apenas 100 gramas e preço inicial de US$ 1.299,99 (cerca de R$ 6.656). O lançamento está previsto para 2027 nos Estados Unidos.
A empresa colocou bateria, armazenamento e processamento em um dispositivo externo chamado puck, conectado por cabo óptico, enquanto os óculos ficam com a tela e os sensores. A Meta também integrou sua inteligência artificial ao sistema, permitindo interação com o Meta AI por voz, movimentos dos olhos e gestos, além de recursos como áudio espacial com Dolby Atmos e Hologram Calling para chamadas em 3D em tempo real.
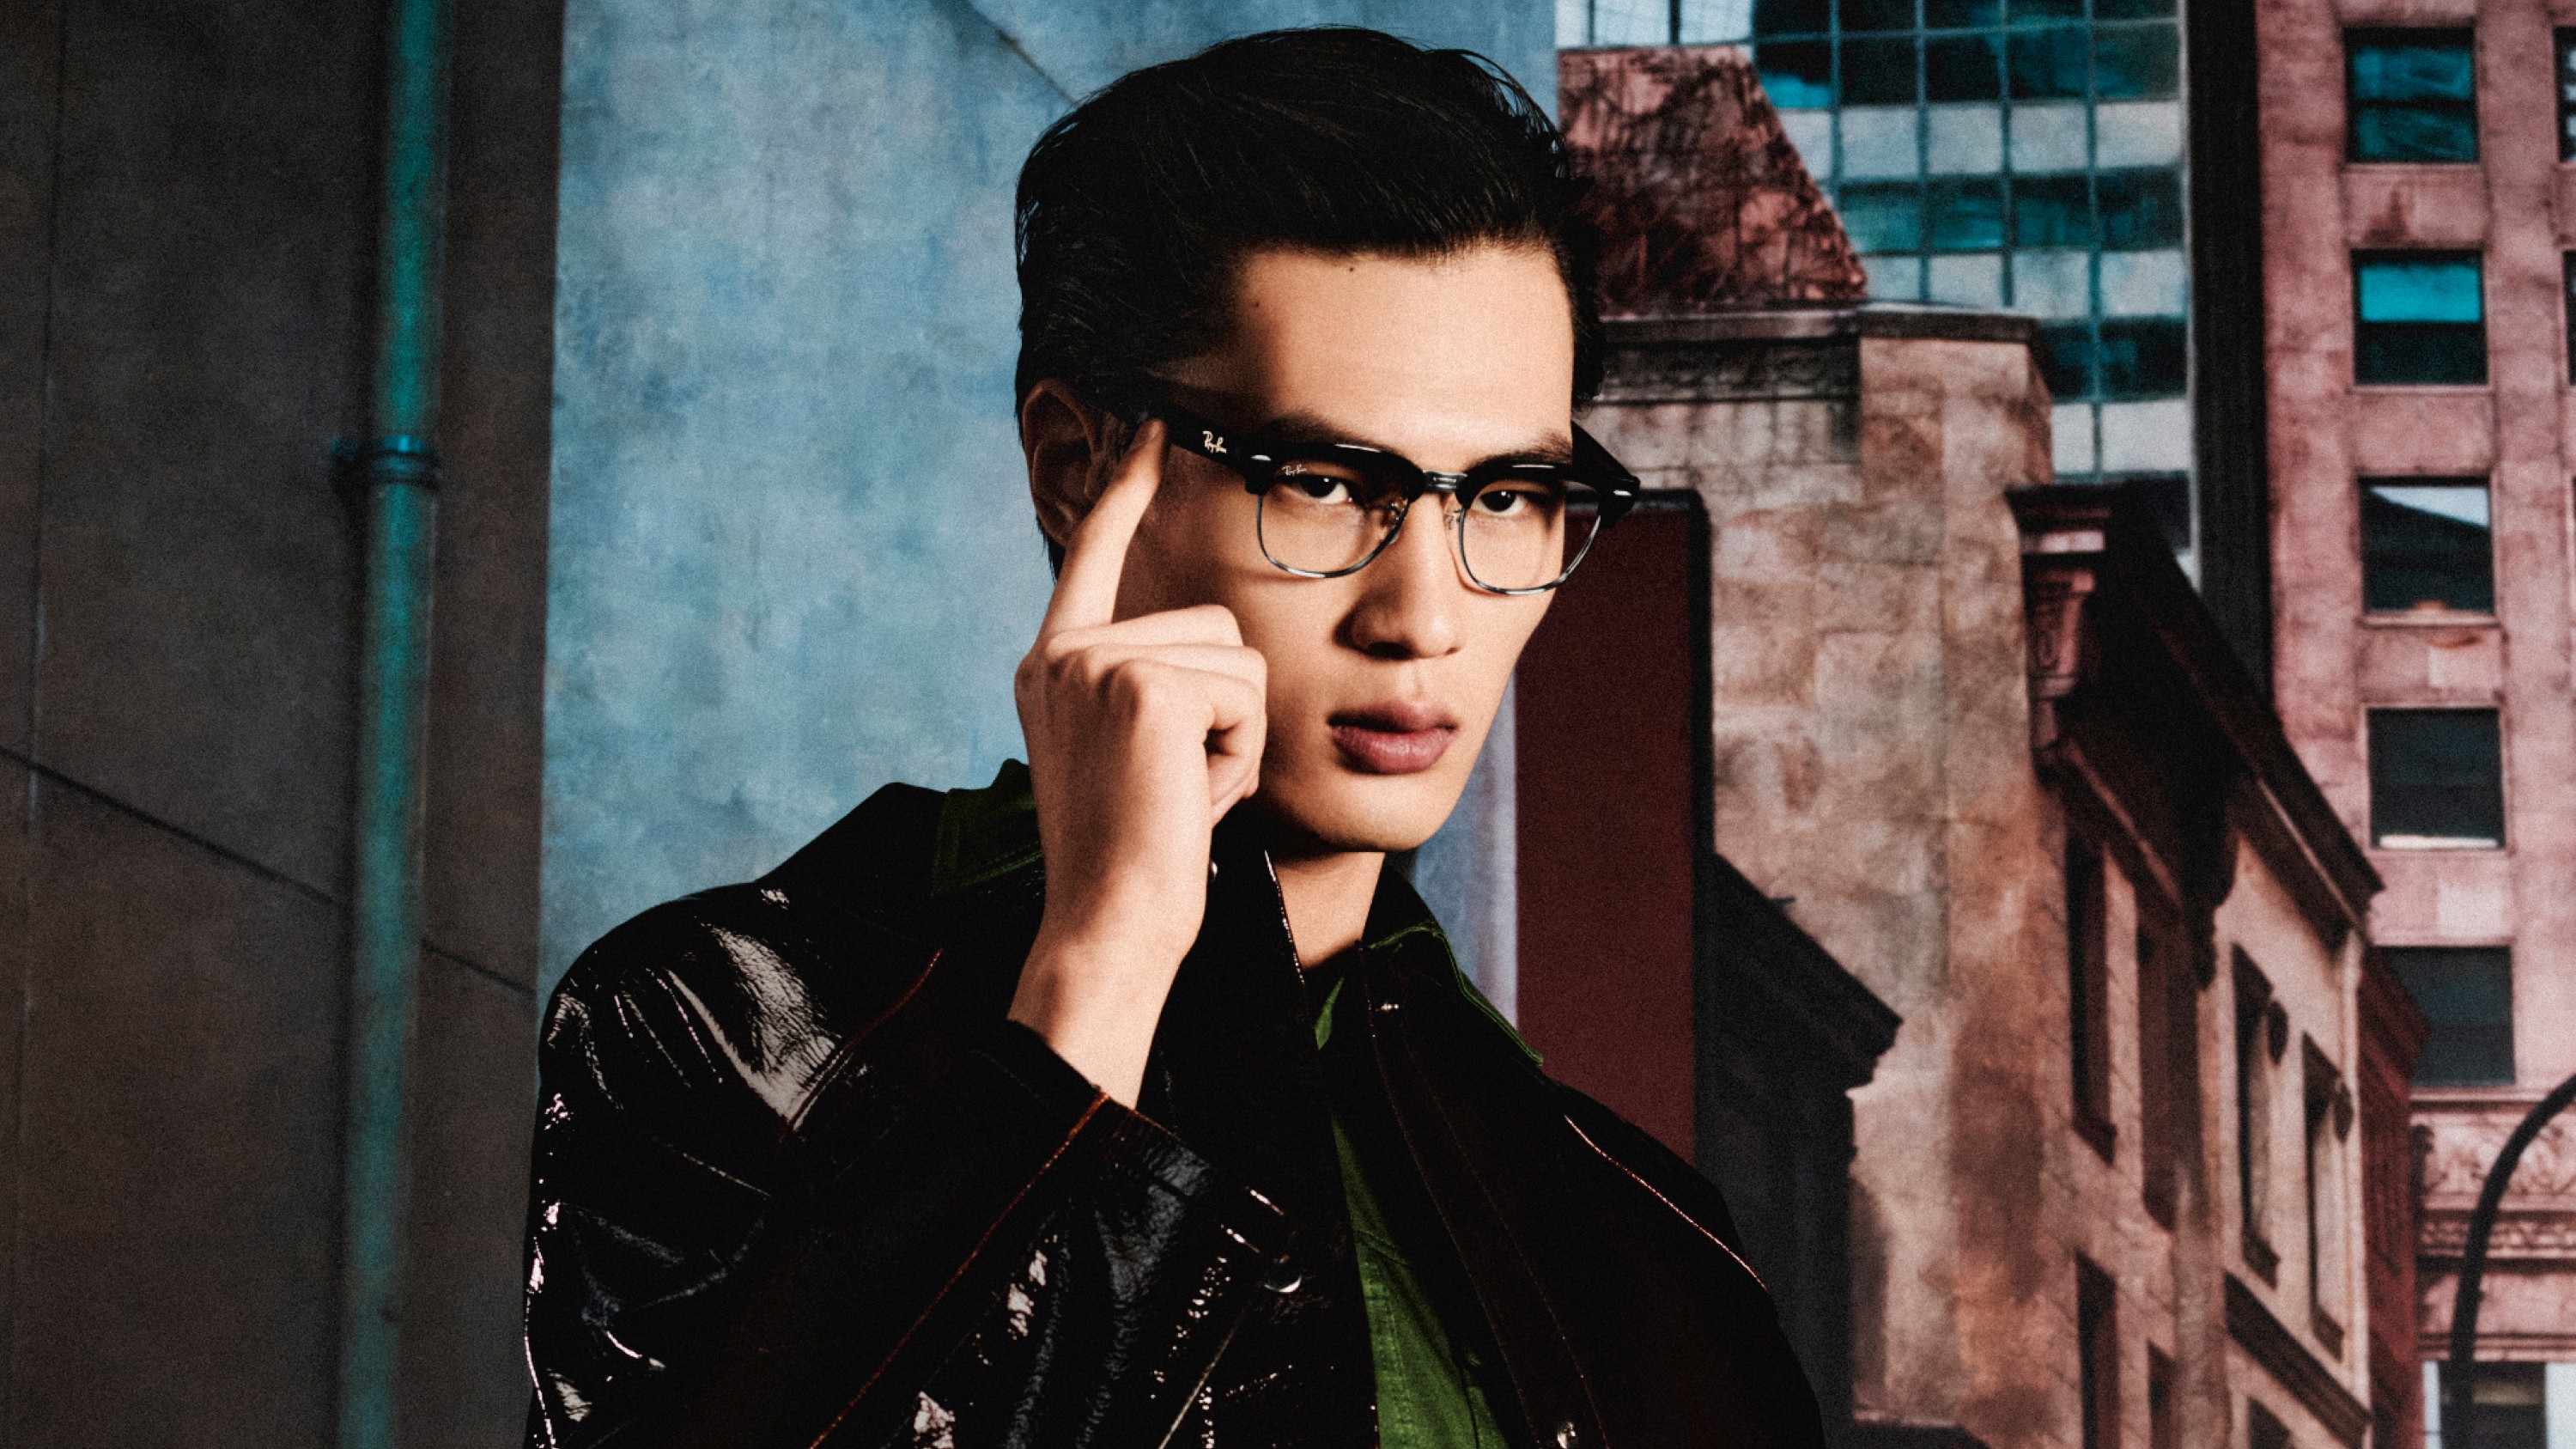
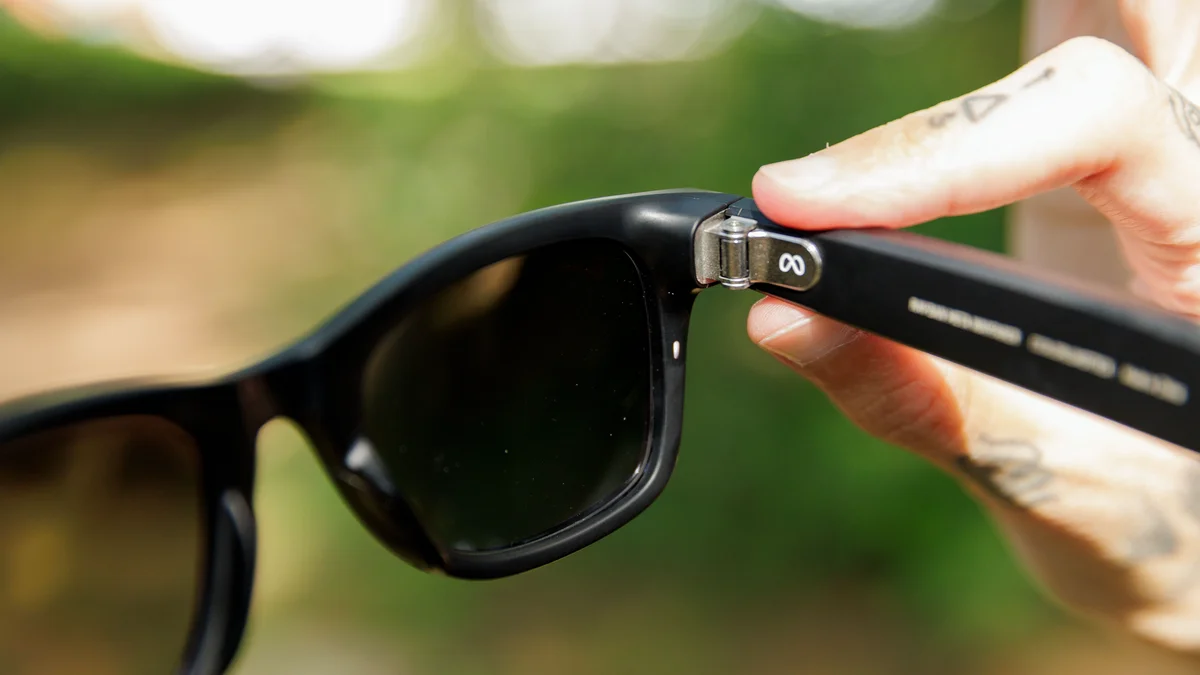
A Meta lançou na quarta-feira (23) os Ray-Ban Meta Audio, óculos inteligentes sem câmera, em meio a reclamações sobre a possibilidade de gravar vídeos de pessoas sem que elas percebam. O dispositivo foi criado para captar a voz do usuário com mais clareza em ligações e também permite ouvir música e podcasts sem usar as mãos.
Os Ray-Ban Meta Audio são compatíveis com o Muse, agente de IA da Meta lançado no início de setembro, que pode oferecer orientações de treinos, registrar refeições, pesquisar na internet, organizar a agenda e comprar produtos. A Meta afirma que os óculos funcionam por até 12 horas com carga completa, pesam 43 gramas e custam a partir de US$ 349 nos EUA; a empresa disse que vai lançar no Brasil, mas sem divulgar preços.
A OpenAI anunciou a chegada de recursos “agentic” baseados em voz ao aplicativo mobile do ChatGPT, permitindo que usuários disparem fluxos de trabalho como rascunhar documentos e resumir e-mails. Assinantes Plus e Pro terão acesso à aba Work no celular para criar documentos, redigir e-mails e resumir mensagens do Slack, além de funções como construir sites, criar apresentações, usar o navegador em nuvem e acessar áreas como finanças no ChatGPT.
A empresa também disse que as conversas de voz do ChatGPT terão uma saída de texto mais rica, com possibilidade de alternar facilmente entre texto e voz. Plus poderá iniciar tarefas na conversa pelo celular e retomar no desktop, enquanto usuários Free e Go terão acesso a plugins e apps conectados; o lançamento acompanha a tendência de mais pessoas usarem comandos por voz para tarefas complexas com assistentes de IA.
A Logitech G lançou o Blue Yeti 2, sucessor do microfone USB Blue Yeti, com upgrades voltados a criadores de conteúdo. O modelo traz um display LED interativo, remoção de ruído com IA e um sensor de voz por proximidade que acompanha a fala em 3D para ajustar automaticamente ganho, EQ e o padrão de captação conforme a distância do usuário.
O Blue Yeti 2 oferece captura em até 24-bit/48 kHz e inclui DSP integrado para melhorar a clareza sem depender de software adicional. O microfone chega nas cores preto e branco por US$ 159,99 e mantém um design semelhante ao do OG Yeti, agora com o sensor para reduzir a confusão comum de falar na parte superior do equipamento.
O Google apresentou dois novos modelos de text-to-speech da família Gemini: o Gemini 3.8 Flash TTS e o Gemini 3.8 Flash-Lite TTS. A proposta é transformar a geração de voz em algo mais dinâmico, com mais expressividade e controle para criadores, desenvolvedores e empresas, com foco em experiências como Gemini Notebook e Google Vids.
O Gemini 3.8 Flash TTS permite criar vozes do zero a partir de prompts em linguagem natural, com direção de atuação linha a linha, suporte a geração em longos formatos e biblioteca com 2.000+ vozes prontas para produção. Já o Gemini 3.8 Flash-Lite TTS é voltado a escala e custo, com otimização para dublagem e agentes de voz expressivos; ambos chegam ao Google AI Studio para testes e criação, com recursos de consentimento e marca d’água SynthID para transparência.
O assistente de IA Muse, da Meta, foi alvo de uma falha zero-day que permite que apps locais e comandos no terminal obtenham controle total do agente. A vulnerabilidade expõe um token de autenticação do usuário e possibilita que processos alterem configurações internas, incluindo o endpoint usado para a transcrição de voz, que normalmente é operado pela Meta.
A descoberta foi atribuída ao especialista em segurança Patrick Wardle, que relatou ter desenvolvido provas de conceito com ações como gravação de arquivos maliciosos e captura de imagens. Após mais de 12 horas do anúncio da falha, a Meta lançou um hotfix para corrigir o problema, e a Amazon também começou a bloquear o Muse em seu site por violar as condições de uso.
Empresas de tecnologia apostam em óculos inteligentes e outros dispositivos com inteligência artificial como sucessores dos smartphones, mas a privacidade virou o principal obstáculo. Esses aparelhos conseguem observar, ouvir e responder ao ambiente, o que aumenta o risco de capturar imagens e vozes de pessoas sem consentimento.
A reação foi especialmente forte contra os óculos inteligentes da Meta, que combinam o formato da EssilorLuxottica com recursos de IA. O caso envolve processos judiciais, preocupações de usuários e restrições de uso no Reino Unido, com alegações de gravações enviadas a servidores da Meta e visualizadas por equipes ligadas ao treinamento de sistemas de IA; a empresa contesta e diz que há luz indicadora e filtros para remover dados identificáveis. Enquanto isso, Samsung, OpenAI e startups testam alternativas como óculos sem câmera, gravação com ativação manual e processamento local no dispositivo.
O assistente pessoal de IA Muse, da Meta, teve uma vulnerabilidade de dia zero poucas semanas após o lançamento. A falha poderia permitir que um invasor assumisse o controle do assistente em um Mac e usasse os privilégios já concedidos ao Muse para executar ações no computador.
O problema foi identificado por Patrick Wardle, que descreveu como a falha poderia alterar a configuração ligada à transcrição de voz, trocando o endereço do servidor usado no processo. Com isso, o atacante poderia obter o token de autenticação da conta do Muse e manter o controle do agente, sem necessariamente instalar malware; a Meta respondeu com um hotfix cerca de 12 horas depois.
O Google prepara uma reorganização da interface do app do Gemini para Android para reunir configurações hoje espalhadas em diferentes menus. A mudança foi identificada na versão 17.60.13.sa.arm64 do aplicativo, em uma análise de código (APK teardown) feita pelo Android Authority.
Com a reformulação, opções que ficam escondidas no alternador de contas devem passar para uma área dedicada chamada “Configurações”, dividida em “Preferências”, “Dados e privacidade” e “Obter suporte”. A atualização também inclui páginas para “Voz” e “Controles do dispositivo”, além de uma seção “Tasks on Android” com a opção “Permitir execução remota”, mas o Google ainda não divulgou quando a novidade chega aos usuários.
Assistente de IA no trabalho virou experimento pessoal: a autora criou “clones” de seus editores usando Gemini, tentando moldar sua própria comunicação e estilo para parecer uma colega melhor. O primeiro, o “Brian Bot”, foi montado com dados públicos e materiais como transcrições e páginas de relações públicas, mas gerou respostas que não batiam com o comportamento do Brian real e ainda reproduziu temas inventados, levando à interrupção do bot em menos de 24 horas.
Depois, a autora partiu para o “Sophie Bot”, alimentando o Gemini com cerca de um mês de conversas no Slack (sem conteúdo sensível). A IA gerou relatórios e prompts a partir de mais de 17.000 palavras, e as interações mostraram que os “bots” conseguem imitar a voz e o ritmo dos editores — ao mesmo tempo em que podem produzir falhas e exageros que tornam a experiência bem diferente da conversa humana.
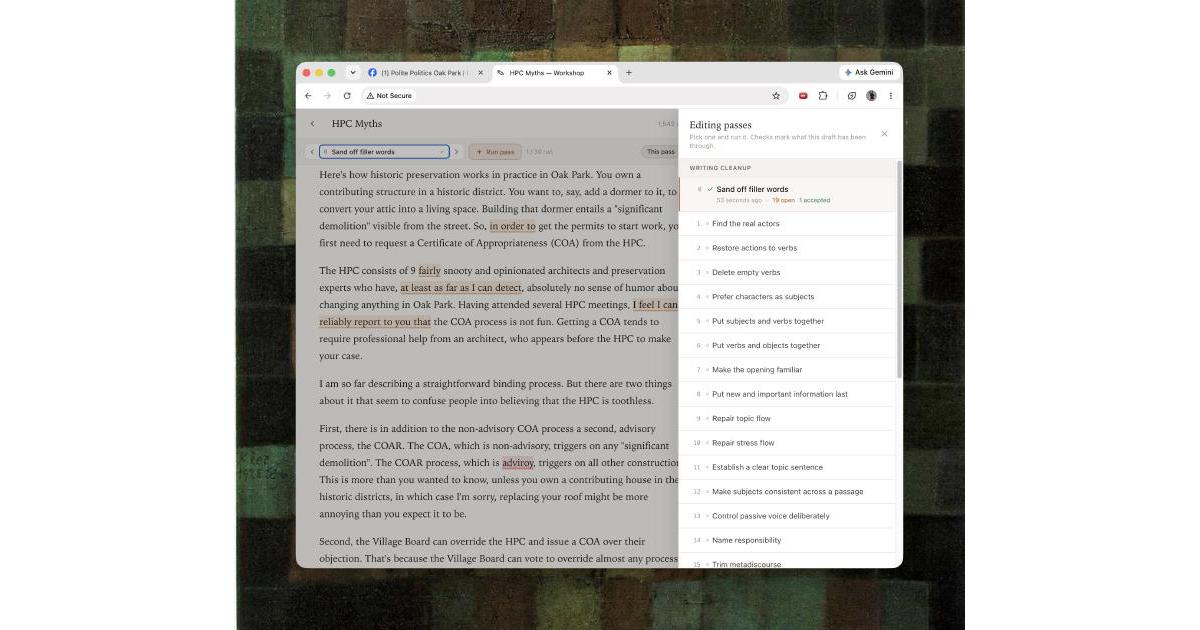
Um guia propõe duas regras para usar modelos de linguagem (LLMs) como revisores de texto, sem “pasteurizar” a escrita. A recomendação é escrever primeiro por conta própria e, depois, pedir a um modelo para identificar falhas. O texto alerta que leitores tendem a perceber quando o resultado parece “output” de IA, mesmo após tentativas de humanização.
As regras centrais dizem para não usar nenhuma palavra ou expressão que o LLM sugira e para evitar qualquer tipo de incentivo do modelo. Em vez de aceitar elogios sobre estrutura e escolhas, o guia orienta a tratar o modelo como ferramenta para apontar problemas — como excesso de voz passiva, repetições e palavras de reforço — e aplicar correções em passes, com reescritas e comparação cuidadosa.
A Meta prepara novos óculos inteligentes sem câmera, chamados internamente de Luna, para serem apresentados na conferência Connect, marcada para 23 e 24 de setembro. As entregas estão previstas para outubro, com foco em oferecer recursos de inteligência artificial sem o componente que mais gera críticas.
O Luna deve chegar em dois estilos, Clubmaster e Burbank, com seis microfones, alto-falantes direcionados aos ouvidos e um botão lateral para acionar rapidamente a Meta AI. A mudança ocorre após questionamentos sobre privacidade ligados a gravações sem conhecimento de outras pessoas, e a empresa também ajustou o sistema de aviso por LED e corrigiu brechas relacionadas ao indicador.
A Meta planeja lançar ainda no outono do Hemisfério Norte um novo modelo de óculos inteligentes sem câmera, segundo informações do The Information. O dispositivo, desenvolvido internamente sob o codinome Luna, marca uma mudança em relação aos óculos atuais da empresa, que incluem câmeras para captura de imagens e vídeos.
A retirada da câmera ocorre em meio ao aumento do escrutínio sobre recursos de gravação em óculos inteligentes. Ainda assim, o Luna deve manter seis microfones para conversas por voz com o chatbot de IA da Meta e com o Muse, além de um botão lateral para ativar rapidamente a Meta AI; a apresentação pode acontecer na conferência Connect, com início das entregas em outubro, mas a empresa não comentou e não há detalhes sobre preço e disponibilidade.
A Meta anunciou um servidor MCP (Model Context Protocol) para permitir que agentes de codificação como Claude e Codex configurem o WhatsApp Business. Com a integração, o desenvolvedor conecta o agente, faz login na conta da Meta e escolhe quais empresas ele pode acessar, limitando o escopo do acesso.
O agente pode lidar com etapas como adicionar número e nome de exibição, receber o código único de verificação por SMS ou voz e registrar a conta para envio de mensagens. Depois do onboarding, ele também pode criar e gerenciar templates, testar envios, sugerir templates quando a janela de 24 horas expira e configurar webhooks para eventos e mensagens recebidas, com ações registradas e mudanças exigindo autenticação humana.
Agentes de voz enfrentam um problema de latência quando precisam executar tarefas reais, e Google e OpenAI lançaram soluções diferentes em poucos dias. A Google colocou no ar o Gemini 3.8 Live e o Gemini 3.8 Live Extended Thinking via Gemini API e Google AI Studio, enquanto a OpenAI lançou o GPT-Live-1 para manter a conversa em tempo real enquanto o trabalho acontece em segundo plano.
No Gemini 3.8 Live Extended Thinking, fala, raciocínio e execução de ferramentas ficam dentro de uma mesma sessão com chamadas assíncronas não bloqueantes, permitindo que o modelo continue falando. Já o GPT-Live-1 separa a conversa do raciocínio e das tool calls em uma camada de backend, exigindo mais orquestração na aplicação para coordenar contexto e lidar com interrupções, além de impactar custos e cobrança por minuto.