Modelos menores de inteligência artificial podem estar a poucos meses de conseguir se replicar em dispositivos conectados à internet sem ajuda humana, segundo alerta da Anthropic. A empresa testou essa capacidade em aparelhos como televisores com Android e eletrodomésticos inteligentes.
O avanço chama atenção para os riscos de disseminação automática de IA em ambientes do dia a dia, fora do controle direto de usuários. Com a replicação em dispositivos domésticos, cresce a necessidade de avaliar segurança e limites para esse tipo de tecnologia em produtos conectados.
A Meta anunciou a série de modelos de inteligência artificial Muse Wonder, com versões Muse Wonder e Muse Wonder Full, voltadas a executar tarefas complexas com mais autonomia. Os agentes contam com memória entre conversas e conseguem manter um objetivo mesmo diante de erros, com aplicações que vão de organização de finanças pessoais à análise de contratos e ao desenvolvimento de softwares.
O Muse Wonder já está disponível para desenvolvedores e criadores via Meta Model API e Muse Code, enquanto o Muse Wonder Full é exclusivo para assinantes do Muse Code. A Meta diz que os modelos usam Active Memory para recuperar informações relevantes de interações anteriores e Active Focus para perseguir objetivos, testar abordagens, corrigir erros e solicitar confirmação do usuário antes de ações importantes, além de reforçar segurança e proteção de dados.
Um engenheiro da OpenAI é acusado de esconder um dispositivo de gravação de áudio em um pedaço de papel higiênico e instalá-lo atrás de um monitor em uma sala de reuniões executivas em um escritório em São Francisco. Segundo uma queixa criminal tornada pública, Abdulrahman Alfozan teria passado semanas consultando um “productivity agent” e um chatbot de IA para planejar a operação, incluindo o uso de uma ferramenta interna para checar reuniões no local.
A acusação também afirma que ele teria usado uma conta de chatbot ligada à esposa para tirar dúvidas técnicas sobre a instalação do equipamento. Após uma varredura de contravigilância em 30 de setembro, a equipe de segurança da OpenAI encontrou o dispositivo e acionou o FBI, além de desativar gradualmente o acesso de Alfozan aos sistemas da empresa durante a investigação.
A JetBrains lançou o Junie Local, uma versão gratuita do agente de codificação Junie para rodar inteiramente na máquina do desenvolvedor, sem depender de modelos em nuvem. A proposta é manter o código local, evitar custos por requisição de API e permitir trabalho em ambientes sem internet.
O Junie Local faz o download do modelo e do motor de inferência ao executar /local, inicia um servidor local e troca o agente automaticamente. Ele usa o Qwen3.6-27B em 4-bit e exige macOS 26, pelo menos 64 GB de memória unificada e um Apple M5 (ou mais recente), com cerca de 20 GB de downloads; a JetBrains afirma que esse requisito alto é o custo para rodar um modelo de 27B com boa qualidade hoje.
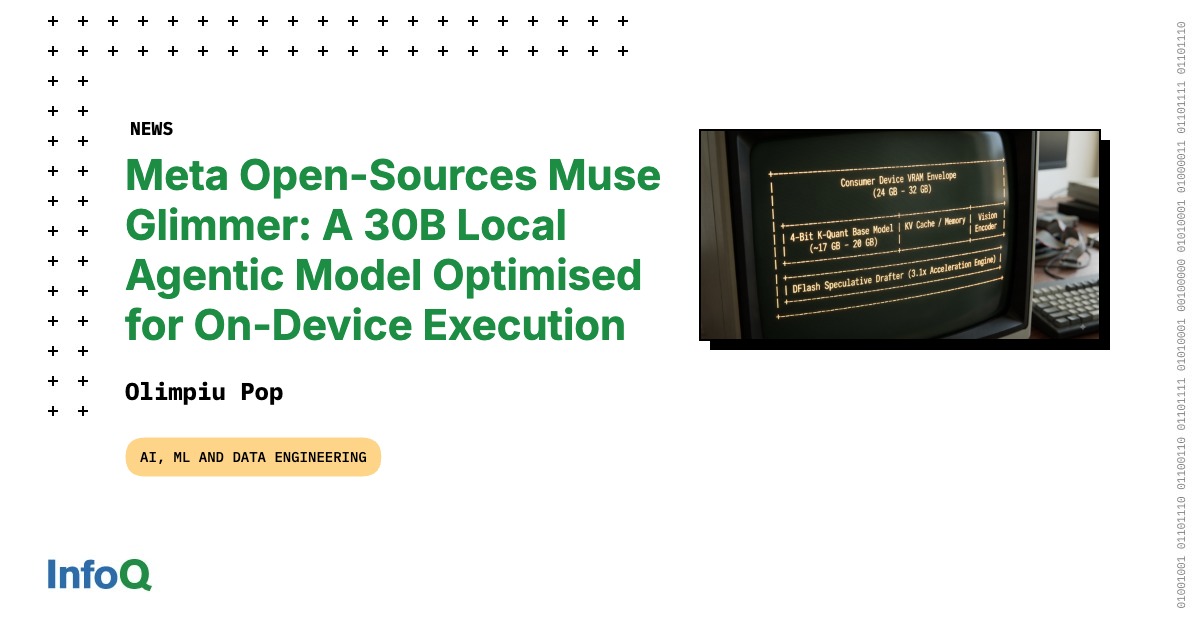
A Meta AI Research lançou o Muse Glimmer, um modelo open-weight de 30 bilhões de parâmetros sob licença Apache 2.0. Projetado para execução local “always-on”, ele permite que desenvolvedores rodem agentes autônomos, invocação complexa de ferramentas, execução de código e avaliações “LLM-as-a-judge” diretamente em GPUs e workstations, sem depender de APIs em nuvem.
Para caber em orçamentos de memória de hardware comum, o Muse Glimmer usa quantização dinâmica 4-bit para reduzir o tamanho para cerca de 17 GB a 20 GB e combina um “drafter” DFlash para validar blocos com múltiplos tokens em paralelo, com ganhos de throughput reportados de até 3,1x. O modelo também inclui um encoder de percepção de 1,8B para inputs multimodais e foi treinado para diagnosticar falhas (como erros de chamadas de API ou comandos no terminal) e tentar caminhos alternativos, com suporte a frameworks como OpenClaw.
O llama.cpp passa a oferecer uma forma de rodar “frontier AI” diretamente na máquina do usuário, com foco em privacidade e execução local. O fluxo destacado inclui usar o comando “llama serve”, instalar o plugin “pi-llama” e iniciar o Pi para que ele descubra automaticamente os modelos locais, sem necessidade de chaves de API e sem telemetria.
A proposta também inclui compatibilidade com diferentes hardwares, do laptop a clusters, usando o mesmo binário e modelos. Entre os modelos citados para execução estão Qwen 3.6, Gemma 4, GPT-OSS, Gemma 3, além de suporte a raciocínio multimodal, agentic workflows e idiomas em escala, como 140+ línguas.